Day 0支持|昆仑芯完成MiniMax M2.7模型极速适配

发布时间:2026-04-13 09:30
作者:AMEYA360
来源:昆仑芯
阅读量:1124

Day 0支持|昆仑芯完成MiniMax M2.7模型极速适配

  MiniMax正式开源MiniMax M2.7模型。昆仑芯同步完成对该模型的Day 0适配与深度优化,成为首批实现适配的国产算力厂商之一,再次验证其在主流大模型生态中的敏捷响应能力与广泛兼容能力。

  发布即适配,软硬协同支撑高效落地

  MiniMax M2.7是M2系列的最新一代模型,也是首个深度参与自身迭代的版本。该模型具备自主构建复杂Agent Harness与Skills的能力,可动态更新Memory,并通过强化学习持续优化,实现“模型驱动模型进化”的闭环。在能力表现上,M2.7已覆盖从代码生成、日志排障到端到端项目交付的完整软件工程链路:SWE-Pro基准达到56.22%,整体表现追平GPT-5.3-Codex;在专业办公场景中,GDPval-AA评分位居行业前列,并在40个复杂Skills(>2000 Token)任务中保持97%的指令遵循率,展现出优异的稳定性与执行能力。

  在实际适配过程中,昆仑芯依托自研架构,持续提升算子覆盖与生态兼容能力,实现模型性能与算力效率的高效匹配。通过底层算子优化与软硬件协同加速,MiniMax M2.7已在昆仑芯平台上实现高吞吐、低延迟的稳定运行,并在复杂任务与长序列场景下保持优异表现。

  为充分释放产品性能,昆仑芯构建了面向开发者的全栈软件体系,完整覆盖从底层驱动到开发工具SDK及专业库的完整能力,兼顾高效易用与工程化落地。该软件栈高度兼容主流AI开发生态,在显著降低开发门槛的同时,最大化释放计算性能,帮助客户以更低适配成本和更短部署周期完成模型开发与落地,加速模型从研发到应用的转化。

  常态化Day 0响应,夯实国产AI算力底座

  近期,国产大模型生态迎来密集升级,技术突破与产业落地节奏持续加快。昆仑芯已完成对多款主流大模型的首发适配,稳步实现“发布即支持”的快速落地能力,推动模型技术迭代与算力底座实现同频演进,充分体现其在软硬协同、生态兼容与工程化落地方面的综合实力。同时,该能力有效降低了模型部署与应用门槛,进一步加快AI应用的规模化拓展。

  当前,昆仑芯正持续深化模型适配与性能优化能力,全面支持多样化架构与算法创新,不断提升开发与部署效率。面向未来,昆仑芯将进一步强化对主流前沿模型的高效适配能力,依托持续的技术创新与软硬协同优势,不断夯实国产AI算力底座,助力产业智能化升级与数字化转型加速推进。

Day 0支持|昆仑芯完成MiniMax M2.7模型极速适配


(备注:文章来源于网络,信息仅供参考,不代表本网站观点,如有侵权请联系删除!)

在线留言询价

相关阅读
极速响应,生态共建|昆仑芯完成MiniMax M3.1 Flash模型Day 0适配
  今日,MiniMax M3.1 Flash模型权重正式释放。昆仑芯同步完成该模型的Day 0适配,成为首批完成该模型适配的国产算力厂商之一,展现了面向前沿大模型的快速响应能力与生态兼容实力。据悉,MiniMax M3.1 Flash是MiniMax推出的新一代Flash模型,重点面向复杂Agent任务、软件开发、Computer Use及网络安全等场景。在复杂任务处理方面,模型支持多步骤规划、工具调用与企业工作流执行;在软件开发方面,提升了对代码理解、功能开发、问题修复及测试验证等任务的支持能力;在计算机操作方面,进一步强化了跨应用交互与连续任务执行能力。昆仑芯持续跟进MiniMax系列模型的技术演进,深化芯模协同,已先后完成MiniMax M2.7、M3、H3等多款模型的Day 0适配。此次MiniMax M3.1 Flash模型权重开放后,昆仑芯团队第一时间开展适配,围绕关键算子、软硬件协同及多卡通信等环节进行优化,并完成模型部署验证,为用户在昆仑芯国产算力平台上开展模型部署、运行测试与应用探索提供支持,助力模型实现权重开放后快速部署。  深化软硬件协同,完善模型适配能力  随着大模型架构持续演进、应用场景不断拓展,算力平台不仅需要满足不同模型的运行要求,还需要通过软件栈适配、算子优化与软硬件协同,提升模型部署效率与运行表现,为模型从开发验证走向实际应用提供支撑。围绕这一需求,昆仑芯持续完善自研软件栈,完整覆盖从底层驱动、开发工具SDK到专业库等核心组件,并围绕主流模型架构与AI开发生态开展适配和优化,为模型迁移、性能调优及规模化部署提供基础支撑。依托自研软件栈与软硬件协同优化能力,昆仑芯能够针对不同模型架构及其运行特点开展适配与调优,提升模型在国产算力平台上的兼容性与部署效率,缩短模型从发布到平台落地的周期,为开发者开展模型开发、部署验证及后续优化提供便利。  持续拓展模型覆盖,推动算力与开源生态协同  开源模型生态加速发展,模型架构、开发框架与应用需求日益多样化。算力平台对主流模型及开发框架的兼容程度、适配效率和工程化支持能力,正成为连接模型创新与应用落地的重要环节。昆仑芯积极跟进主流开源模型及相关技术发展,持续推进模型适配与性能优化,适配范围已覆盖文本、多模态、图像生成等多类模型,不断拓展对不同模型架构及应用场景的支持能力。从模型发布后的快速响应,到面向不同架构的深度适配与优化,昆仑芯持续完善模型适配体系,推动国产算力平台与主流开源模型及开发框架有效衔接,为企业和开发者提供更加丰富的模型部署与应用选择。未来,昆仑芯将继续紧跟前沿大模型发展趋势,深化与模型厂商、开源社区及生态伙伴的协同合作,持续提升模型适配效率、平台兼容能力与工程化水平,推动国产算力与大模型生态协同发展,为人工智能应用创新与落地提供坚实的算力支撑。
2026-10-23 11:12 阅读量:162
昆仑芯与openEuler完成兼容性互认证,持续拓展国产算力生态协同
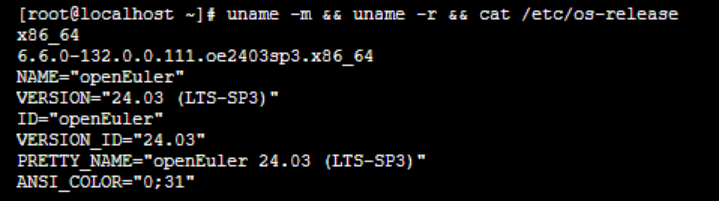
  近日,OpenAtom openEuler(简称 “openEuler” 或 “开源欧拉”)与昆仑芯P800系列产品完成兼容性互认证。双方围绕系统与设备识别、驱动及软件环境、链路与设备互联等关键环节开展验证,共七项子测试全部通过,验证了昆仑芯P800产品与openEuler在基础软硬件运行环境层面的兼容性,为国产算力产品在开源操作系统中的部署应用提供实践支撑。  此次认证是昆仑芯持续推进主流软硬件生态适配、深化生态协同的又一实践。通过与开源操作系统开展兼容性验证,进一步夯实算力产品与基础软件环境之间的协同基础,为后续开展AI框架适配、模型部署及业务验证创造条件。  深化软硬件适配,推动算力生态协同发展  随着AI算力应用不断拓展,算力产品的实际落地不仅依赖硬件能力,也需要操作系统、驱动、软件环境及设备互联等基础设施的协同支撑。软硬件兼容性是保障算力平台稳定部署和应用运行的重要基础。  本次兼容性互认证围绕系统识别、软件环境部署及链路互联等环节展开,重点验证openEuler对昆仑芯P800产品的识别能力、驱动与SDK部署情况,以及主机与设备、设备与设备之间的链路及互联能力。  测试结果显示,openEuler系统能够正确识别昆仑芯P800,驱动与SDK部署顺利,设备状态正常,设备互联相关测试均达到预期,七项子测试全部通过。  测试首先记录了操作系统基础信息,确认openEuler运行环境可用:  驱动安装完成后,系统可正确识别昆仑芯P800,并确认设备已绑定对应内核驱动、设备状态正常:  本轮验证覆盖基础运行环境中的多个关键环节,进一步打通国产AI加速卡与开源操作系统之间的软硬件协同通路,为算力产品融入多元化技术生态、拓展应用场景提供实践参考。  持续拓展主流生态适配,完善国产AI软硬件协同体系  人工智能产业的快速发展,正在推动算力生态从单一硬件能力竞争,向芯片、操作系统、AI框架、模型及应用等多层次协同演进。完善的软硬件生态适配能力,是降低用户部署门槛、提升算力应用效率、推动国产算力规模化落地的重要支撑。  围绕AI算力生态建设,昆仑芯持续推进与主流软硬件生态的适配与协作,现已构建覆盖基础软件、AI框架、模型及应用场景的完善的国产AI软硬件生态圈。在基础软件生态层面,昆仑芯积极推进与主流操作系统及相关软件环境的兼容验证,持续夯实算力产品的基础运行环境;在AI框架与模型生态层面,围绕主流框架及大模型开展适配、优化与部署验证,推动模型能力在昆仑芯算力平台上的应用;同时,通过与生态伙伴开展联合适配与技术协作,提升软硬件协同效率,促进适配成果向更多业务场景延伸。目前,昆仑芯已围绕多类主流软硬件生态开展适配与协同实践,持续拓展生态合作范围,推动算力能力与上层软件、模型及应用之间的衔接。  此次与openEuler完成兼容性互认证,是昆仑芯持续拓展主流软硬件生态适配范围的又一实践。通过基础运行环境验证,进一步夯实了昆仑芯算力产品与开源操作系统之间的协同基础,也为后续开展更深层次的软件适配与业务验证创造了条件。  未来,昆仑芯将持续加强与主流操作系统、AI框架、模型生态及产业伙伴的合作,推进软硬件适配成果积累与生态能力建设,逐步完善从底层运行环境到上层模型应用的协同体系,推动国产算力与开放软件生态深度融合,为用户提供更加开放、便捷、高效的算力应用环境,助力人工智能产业创新发展。
2026-10-21 09:52 阅读量:197
深化芯模协同,共筑开放AI生态|昆仑芯完成阶跃星辰Step 5 Preview模型Day 0适配
  今日,基础大模型公司阶跃星辰正式开源新一代旗舰基座模型Step 5 Preview。模型开源当日,昆仑芯即完成对Step 5 Preview的适配与联合精调,成为首批完成该模型适配的国产算力厂商之一,展现了面向前沿大模型的快速响应能力与生态兼容实力。据悉,Step 5 Preview模型面向长程Agent任务设计,采用稀疏MoE架构,总参数量达600B,每个Token仅激活27B参数,支持100万Token上下文窗口,并原生支持文本与视觉输入,在AI编程、软件工程、专业知识工作、金融等场景中表现突出。近期,Step 5 Preview在OpenRouter周调用量和日调用量榜单中均位居全球第二。此次适配过程中,昆仑芯围绕Step 5 Preview的模型架构与关键算子开展针对性优化,结合其超长上下文、稀疏MoE等技术特点,通过底层算子优化与软硬件协同,提升模型运行效率、稳定性与资源利用水平,为复杂智能体任务提供高效算力支持。  软硬协同优化,提升模型适配与部署效率  此次与阶跃星辰围绕Step 5 Preview开展Day 0适配,是昆仑芯深化主流模型生态合作、提升芯模协同能力的又一实践。快速适配能力的背后,是昆仑芯长期积累的软件生态基础。  昆仑芯持续完善自研软件栈,构建覆盖底层驱动、开发工具SDK、专业库等核心组件的软件体系,并围绕主流模型架构与AI开发生态开展适配和优化,为模型迁移、性能调优及规模化部署提供软件支撑。  依托成熟的软件栈与软硬件协同优化能力,昆仑芯能够面向不同模型架构及应用需求快速开展适配,降低模型迁移与部署成本,缩短模型从发布到算力平台落地的周期。在保障模型稳定运行的同时,进一步提升开发者的模型开发与应用部署效率,为前沿大模型快速进入实际应用提供高效、灵活的算力环境。  持续保持Day 0适配,构建开放协同的模型生态  随着大模型迭代速度不断加快,模型从发布到应用落地的周期不断缩短,对算力平台的快速适配能力与生态兼容性提出了更高要求。除了及时响应单个模型的发布,算力平台还需要不断拓展模型适配范围,满足不同开发者及应用场景的多样化需求。  近一年来,昆仑芯紧跟主流开源模型发展,已完成对头部厂商40余款旗舰模型的快速适配,覆盖文本、多模态、图像生成等多个方向,推动“发布即适配”逐步成为常态。在持续提升模型适配效率的同时,昆仑芯不断丰富平台支持的模型类型,拓展生态兼容边界,为开发者提供更广泛的模型选择与算力支持,助力前沿模型加速落地应用。  面向未来,昆仑芯将进一步加强与国产模型企业及生态伙伴的合作,以“国芯+国模”协同发展为契机,强化对前沿模型架构、算法及应用场景的适配能力,通过软硬件协同优化提升模型与算力平台的适配效率,推动更多前沿模型高效运行于国产算力平台,共建开放协同的国产AI生态,助力AI应用加速走向千行百业。
2026-10-15 13:29 阅读量:254
昆仑芯完成RLinf适配验证,拓展具身智能强化学习开源生态
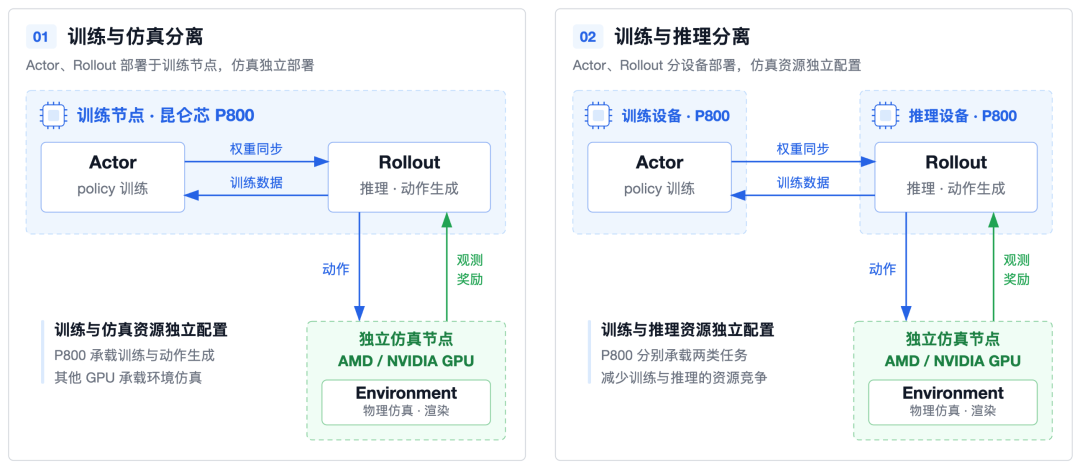
  随着具身智能加速从技术探索走向规模化研发,强化学习正在成为提升机器人自主决策与任务执行能力的重要技术路径。与此同时,具身智能研发对算力平台的兼容性、分布式训练能力以及训练、仿真、推理协同提出了更高要求。  近日,昆仑芯完成具身智能强化学习框架RLinf适配验证,覆盖单节点训练、多节点协同、训练与仿真分离、训练与推理分离等典型场景,并完成Pi系列模型在LIBERO任务上的训练复现,进一步拓展昆仑芯在具身智能强化学习领域的开源生态支持。  接入主流开源框架,拓展应用支持  RLinf是面向具身智能的“仿训推一体化”大规模强化学习框架,由清华大学、无问芯穹联合发起,于2025年9月开源。框架面向具身智能与智能体场景,提供覆盖仿真、训练和推理的统一强化学习基础设施,旨在打通渲染、训练、推理等环节,为开发者提供从仿真环境交互到策略更新的完整强化学习流程,目前已在机器人等相关场景中开展应用。  此次适配中,昆仑芯基于RLinf模块化的硬件接口设计,通过标准插件方式完成Kunlunxin XPU后端接入,无需修改框架既有实现,即可将昆仑芯算力纳入RLinf运行体系,进一步打通设备管理、任务调度与分布式通信等关键环节。  在设备管理与任务调度方面,昆仑芯完成Kunlunxin XPU设备发现、资源配置及Ray调度适配,确保训练任务能够准确使用实际分配的算力资源;在分布式通信方面,以XCCL作为通信后端,支持AllReduce、AllGather等多卡集合通信,打通单节点及多节点强化学习任务的运行基础。  基于上述适配,昆仑芯P800能够在RLinf框架下开展单节点、多节点以及训练、仿真、推理分离等多种运行模式验证,为具身智能强化学习任务提供更加灵活的国产算力支持。  覆盖多种部署模式,提升资源调度灵活性  具身强化学习涵盖训练、仿真与推理等多个环节,对算力资源的配置方式提出了更高要求。基于RLinf,昆仑芯P800完成多种部署模式的适配验证。  其中,在训练与仿真分离模式下,Actor、Rollout部署于训练节点,Environment部署于独立仿真节点,实现训练与仿真资源的独立配置;在训练与推理分离模式下,策略训练与动作生成部署于不同设备,减少不同任务之间的资源竞争。  通过灵活的部署方式,昆仑芯P800进一步拓展了具身强化学习场景下的算力组织方式,为不同规模任务提供更加灵活的资源配置能力。  完成Pi 0.5适配验证,验证具身强化学习应用能力  在实际任务验证中,昆仑芯P800已完成LIBERO Spatial、Object和Goal等任务配置的适配验证。其中,Pi 0.5相关配置覆盖单节点8卡与双节点16卡环境,完成从单节点训练到多节点协同的运行验证。  在libero_spatial_grpo_openpi_pi05配置下,昆仑芯P800完成Pi 0.5模型在LIBERO Spatial任务上的强化学习训练与仿真评测。测试结果显示,在第70个训练step,模型任务成功率达到99.77%,强化训练曲线整体与公开结果呈现相同趋势;相比强化学习训练前,训练后策略成功率提升12.27%。  从训练到仿真评测,昆仑芯P800已跑通基于RLinf的完整强化学习流程。开发者可以沿用RLinf现有开发方式,在昆仑芯平台完成模型训练、策略优化与任务评测,为进一步开展具身智能强化学习研究与应用提供算力支撑。  优化分布式通信,降低多节点同步开销  在具身强化学习任务中,模型权重需要在训练与Rollout等环节之间频繁传递,通信效率直接影响整体运行效率。针对多节点训练中的权重同步开销,基于P800平台进一步优化跨节点通信链路,通过引入混合通信方案提升权重传递效率。  测试结果显示,单节点首个step的权重同步耗时由14.710秒降至3.006秒,多节点首个step由299.0秒降至6.510秒;在后续训练step中,相比仅使用Gloo,混合通信方案仍可节省约40秒的权重同步时间。  上述结果表明,经过通信链路优化,昆仑芯P800能够有效降低多节点强化学习任务中的同步开销,为具身智能强化学习的分布式运行提供更高效的通信支撑。  持续完善开源生态,助力具身智能适配  此次RLinf适配,是昆仑芯持续推进软硬件协同、拓展开源生态的重要实践。  从基础软件、AI框架到模型与应用,昆仑芯持续推进与主流生态的适配、优化与验证,不断拓展算力平台的兼容范围。通过对主流AI框架、大模型及具身智能相关框架的持续适配,昆仑芯不断完善软硬件协同能力与开发环境,降低开发者在国产算力平台上的迁移与验证成本。  目前,昆仑芯已完成包括RLinf在内的强化学习系列框架适配,并推动相关支持贡献至社区主线。未来,昆仑芯将持续加强与开源社区、具身智能产业链及开发者生态的协同,持续拓展主流框架与模型适配,完善软硬件协同的开发环境和生态体系,推动更多模型、框架与应用在昆仑芯平台高效运行,为机器人企业、科研团队及开发者提供更加开放、兼容的国产算力支持。
2026-09-30 16:52 阅读量:299
  • 一周热料
  • 紧缺物料秒杀
型号 品牌 询价
BD71847AMWV-E2 ROHM Semiconductor
TL431ACLPR Texas Instruments
CDZVT2R20B ROHM Semiconductor
RB751G-40T2R ROHM Semiconductor
MC33074DR2G onsemi
型号 品牌 抢购
IPZ40N04S5L4R8ATMA1 Infineon Technologies
BP3621 ROHM Semiconductor
BU33JA2MNVX-CTL ROHM Semiconductor
STM32F429IGT6 STMicroelectronics
TPS63050YFFR Texas Instruments
ESR03EZPJ151 ROHM Semiconductor
热门标签
ROHM
Aavid
Averlogic
开发板
SUSUMU
NXP
PCB
传感器
半导体
相关百科
关于我们
AMEYA360微信服务号 AMEYA360微信服务号
AMEYA360商城(www.ameya360.com)上线于2011年,现 有超过3500家优质供应商,收录600万种产品型号数据,100 多万种元器件库存可供选购,产品覆盖MCU+存储器+电源芯 片+IGBT+MOS管+运放+射频蓝牙+传感器+电阻电容电感+ 连接器等多个领域,平台主营业务涵盖电子元器件现货销售、 BOM配单及提供产品配套资料等,为广大客户提供一站式购 销服务。

请输入下方图片中的验证码:

验证码