深化芯模协同,共筑开放AI生态|昆仑芯完成阶跃星辰Step 5 Preview模型Day 0适配

发布时间:2026-10-15 13:29
作者:AMEYA360
来源:昆仑芯
阅读量:176

  今日,基础大模型公司阶跃星辰正式开源新一代旗舰基座模型Step 5 Preview。模型开源当日,昆仑芯即完成对Step 5 Preview的适配与联合精调,成为首批完成该模型适配的国产算力厂商之一,展现了面向前沿大模型的快速响应能力与生态兼容实力。据悉,Step 5 Preview模型面向长程Agent任务设计,采用稀疏MoE架构,总参数量达600B,每个Token仅激活27B参数,支持100万Token上下文窗口,并原生支持文本与视觉输入,在AI编程、软件工程、专业知识工作、金融等场景中表现突出。近期,Step 5 Preview在OpenRouter周调用量和日调用量榜单中均位居全球第二。此次适配过程中,昆仑芯围绕Step 5 Preview的模型架构与关键算子开展针对性优化,结合其超长上下文、稀疏MoE等技术特点,通过底层算子优化与软硬件协同,提升模型运行效率、稳定性与资源利用水平,为复杂智能体任务提供高效算力支持。

  软硬协同优化,提升模型适配与部署效率

  此次与阶跃星辰围绕Step 5 Preview开展Day 0适配,是昆仑芯深化主流模型生态合作、提升芯模协同能力的又一实践。快速适配能力的背后,是昆仑芯长期积累的软件生态基础。

  昆仑芯持续完善自研软件栈,构建覆盖底层驱动、开发工具SDK、专业库等核心组件的软件体系,并围绕主流模型架构与AI开发生态开展适配和优化,为模型迁移、性能调优及规模化部署提供软件支撑。

  依托成熟的软件栈与软硬件协同优化能力,昆仑芯能够面向不同模型架构及应用需求快速开展适配,降低模型迁移与部署成本,缩短模型从发布到算力平台落地的周期。在保障模型稳定运行的同时,进一步提升开发者的模型开发与应用部署效率,为前沿大模型快速进入实际应用提供高效、灵活的算力环境。

  持续保持Day 0适配,构建开放协同的模型生态

  随着大模型迭代速度不断加快,模型从发布到应用落地的周期不断缩短,对算力平台的快速适配能力与生态兼容性提出了更高要求。除了及时响应单个模型的发布,算力平台还需要不断拓展模型适配范围,满足不同开发者及应用场景的多样化需求。

  近一年来,昆仑芯紧跟主流开源模型发展,已完成对头部厂商40余款旗舰模型的快速适配,覆盖文本、多模态、图像生成等多个方向,推动“发布即适配”逐步成为常态。在持续提升模型适配效率的同时,昆仑芯不断丰富平台支持的模型类型,拓展生态兼容边界,为开发者提供更广泛的模型选择与算力支持,助力前沿模型加速落地应用。

  面向未来,昆仑芯将进一步加强与国产模型企业及生态伙伴的合作,以“国芯+国模”协同发展为契机,强化对前沿模型架构、算法及应用场景的适配能力,通过软硬件协同优化提升模型与算力平台的适配效率,推动更多前沿模型高效运行于国产算力平台,共建开放协同的国产AI生态,助力AI应用加速走向千行百业。
深化芯模协同,共筑开放AI生态|昆仑芯完成阶跃星辰Step 5 Preview模型Day 0适配


(备注:文章来源于网络,信息仅供参考,不代表本网站观点,如有侵权请联系删除!)

在线留言询价

相关阅读
昆仑芯完成RLinf适配验证,拓展具身智能强化学习开源生态
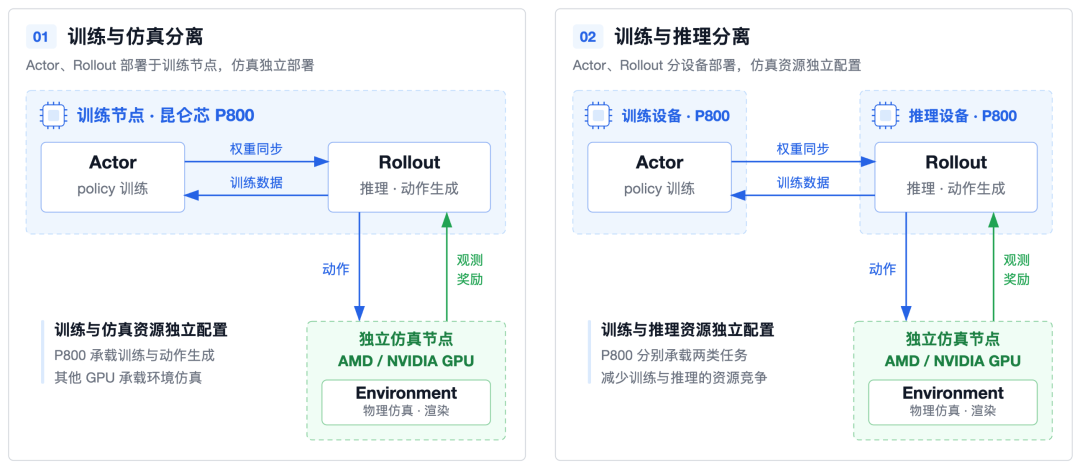
  随着具身智能加速从技术探索走向规模化研发,强化学习正在成为提升机器人自主决策与任务执行能力的重要技术路径。与此同时,具身智能研发对算力平台的兼容性、分布式训练能力以及训练、仿真、推理协同提出了更高要求。  近日,昆仑芯完成具身智能强化学习框架RLinf适配验证,覆盖单节点训练、多节点协同、训练与仿真分离、训练与推理分离等典型场景,并完成Pi系列模型在LIBERO任务上的训练复现,进一步拓展昆仑芯在具身智能强化学习领域的开源生态支持。  接入主流开源框架,拓展应用支持  RLinf是面向具身智能的“仿训推一体化”大规模强化学习框架,由清华大学、无问芯穹联合发起,于2025年9月开源。框架面向具身智能与智能体场景,提供覆盖仿真、训练和推理的统一强化学习基础设施,旨在打通渲染、训练、推理等环节,为开发者提供从仿真环境交互到策略更新的完整强化学习流程,目前已在机器人等相关场景中开展应用。  此次适配中,昆仑芯基于RLinf模块化的硬件接口设计,通过标准插件方式完成Kunlunxin XPU后端接入,无需修改框架既有实现,即可将昆仑芯算力纳入RLinf运行体系,进一步打通设备管理、任务调度与分布式通信等关键环节。  在设备管理与任务调度方面,昆仑芯完成Kunlunxin XPU设备发现、资源配置及Ray调度适配,确保训练任务能够准确使用实际分配的算力资源;在分布式通信方面,以XCCL作为通信后端,支持AllReduce、AllGather等多卡集合通信,打通单节点及多节点强化学习任务的运行基础。  基于上述适配,昆仑芯P800能够在RLinf框架下开展单节点、多节点以及训练、仿真、推理分离等多种运行模式验证,为具身智能强化学习任务提供更加灵活的国产算力支持。  覆盖多种部署模式,提升资源调度灵活性  具身强化学习涵盖训练、仿真与推理等多个环节,对算力资源的配置方式提出了更高要求。基于RLinf,昆仑芯P800完成多种部署模式的适配验证。  其中,在训练与仿真分离模式下,Actor、Rollout部署于训练节点,Environment部署于独立仿真节点,实现训练与仿真资源的独立配置;在训练与推理分离模式下,策略训练与动作生成部署于不同设备,减少不同任务之间的资源竞争。  通过灵活的部署方式,昆仑芯P800进一步拓展了具身强化学习场景下的算力组织方式,为不同规模任务提供更加灵活的资源配置能力。  完成Pi 0.5适配验证,验证具身强化学习应用能力  在实际任务验证中,昆仑芯P800已完成LIBERO Spatial、Object和Goal等任务配置的适配验证。其中,Pi 0.5相关配置覆盖单节点8卡与双节点16卡环境,完成从单节点训练到多节点协同的运行验证。  在libero_spatial_grpo_openpi_pi05配置下,昆仑芯P800完成Pi 0.5模型在LIBERO Spatial任务上的强化学习训练与仿真评测。测试结果显示,在第70个训练step,模型任务成功率达到99.77%,强化训练曲线整体与公开结果呈现相同趋势;相比强化学习训练前,训练后策略成功率提升12.27%。  从训练到仿真评测,昆仑芯P800已跑通基于RLinf的完整强化学习流程。开发者可以沿用RLinf现有开发方式,在昆仑芯平台完成模型训练、策略优化与任务评测,为进一步开展具身智能强化学习研究与应用提供算力支撑。  优化分布式通信,降低多节点同步开销  在具身强化学习任务中,模型权重需要在训练与Rollout等环节之间频繁传递,通信效率直接影响整体运行效率。针对多节点训练中的权重同步开销,基于P800平台进一步优化跨节点通信链路,通过引入混合通信方案提升权重传递效率。  测试结果显示,单节点首个step的权重同步耗时由14.710秒降至3.006秒,多节点首个step由299.0秒降至6.510秒;在后续训练step中,相比仅使用Gloo,混合通信方案仍可节省约40秒的权重同步时间。  上述结果表明,经过通信链路优化,昆仑芯P800能够有效降低多节点强化学习任务中的同步开销,为具身智能强化学习的分布式运行提供更高效的通信支撑。  持续完善开源生态,助力具身智能适配  此次RLinf适配,是昆仑芯持续推进软硬件协同、拓展开源生态的重要实践。  从基础软件、AI框架到模型与应用,昆仑芯持续推进与主流生态的适配、优化与验证,不断拓展算力平台的兼容范围。通过对主流AI框架、大模型及具身智能相关框架的持续适配,昆仑芯不断完善软硬件协同能力与开发环境,降低开发者在国产算力平台上的迁移与验证成本。  目前,昆仑芯已完成包括RLinf在内的强化学习系列框架适配,并推动相关支持贡献至社区主线。未来,昆仑芯将持续加强与开源社区、具身智能产业链及开发者生态的协同,持续拓展主流框架与模型适配,完善软硬件协同的开发环境和生态体系,推动更多模型、框架与应用在昆仑芯平台高效运行,为机器人企业、科研团队及开发者提供更加开放、兼容的国产算力支持。
2026-09-30 16:52 阅读量:269
芯模共生,生态共建:昆仑芯联合FlagOS实现MiniCPM5-2B模型Day 0部署
  近日,面壁智能联合OpenBMB正式开源新一代端侧模型「小钢炮」MiniCPM5-2B。作为面向端侧场景打造的新一代小尺寸模型,该模型原生支持混合思考、512K超长上下文,并具备工具调用、深度搜索、代码生成等智能体能力,可进一步拓展至手机、PC、智能座舱等多元端侧设备。  模型开源后,昆仑芯联合FlagOS,率先完成MiniCPM5-2B的Day 0适配与推理验证。  此次适配展现了昆仑芯面向前沿开源模型的快速响应能力。依托持续完善的软硬件协同体系,昆仑芯能够紧跟主流模型迭代,并通过与FlagOS的生态协同,进一步提升模型适配效率,缩短新模型从开源发布到国产算力平台可用的时间。  开源即适配,昆仑芯联合FlagOS实现模型高效部署  大模型快速迭代的今天,从“模型发布”到“算力可用”的时间窗口正在不断缩短。对于开发者而言,新模型发布后能否快速完成不同算力平台上的适配、部署与性能验证,已经成为衡量算力生态响应能力的重要指标。此次MiniCPM5-2B开源后,昆仑芯联合FlagOS快速完成模型的适配与推理验证,实现了开源即适配、开源即部署。在适配过程中,昆仑芯围绕模型运行涉及的算子、推理框架及运行环境开展逐一验证与优化,依托持续完善的软件体系和软硬件协同能力,推动模型在快速在昆仑芯平台实现稳定运行。与此同时,FlagOS通过统一算子库、编译器及推理插件等软件能力,为模型适配提供统一的软件支撑,进一步降低前沿模型跨芯片适配的复杂度。基于统一多芯片软件栈,此次MiniCPM5-2B的适配成果还可通过FlagRelease发布多芯片模型版本,进一步提升适配成果的复用效率。  软硬协同,昆仑芯持续提升适配效率  大模型适配并非简单地让模型“跑起来”。由于不同AI芯片在计算架构、算子支持、编译环境和软件栈等方面存在差异,新模型要实现稳定、高效运行,需要进行多层次的适配与优化。  对于昆仑芯而言,持续完善软硬件协同能力,提升模型适配与优化效率,是推动前沿模型快速落地的重要基础。  这一适配能力的背后,是昆仑芯长期积累并持续完善的自研软件体系。围绕开发者需求,昆仑芯构建了覆盖底层驱动、开发工具、SDK及专业算子库等核心环节的自研软件栈,为模型迁移、部署与运行提供完善的软件支撑。依托持续演进的软件能力,开发者能够以更低的适配成本和更高的部署效率,将前沿模型快速应用于实际场景。  此次MiniCPM5-2B适配过程中,昆仑芯依托自身软件体系和推理能力完成模型适配与验证,并联合FlagOS进一步提升适配成果的复用效率,为模型在国产AI芯片平台上的快速部署提供支持。  从单个模型的Day 0快速响应,到持续拓展主流模型生态,昆仑芯正不断拓展对前沿模型的兼容与支持能力,持续缩短模型从开源发布到国产算力平台落地的时间,让更多前沿模型能够更加高效地运行在国产算力平台之上。  深化生态协同,共建繁荣模型生态  随着大模型加速迭代,模型生态与算力生态之间的协同效率愈发重要。对于国产算力而言,除了具备稳定的硬件性能,还需要持续提升对主流模型的兼容与适配能力,才能更好承接前沿模型的发展。  昆仑芯正持续跟进主流开源模型迭代,不断提升模型适配与优化效率,当前已完成智谱GLM系列、Qwen系列、MiniMax、Kimi等多款主流模型的适配,持续拓展对主流模型生态的支持范围。  在不断提升自身适配能力的同时,昆仑芯也积极参与众智FlagOS社区等开源生态建设,通过与生态伙伴开展联合适配,推动模型适配成果进一步复用和共享,扩大国产算力对主流模型生态的支持范围。  未来,昆仑芯将持续提升前沿模型的适配与优化能力,深化模型、软件与芯片之间的协同,与生态伙伴共同推动更多前沿模型快速落地国产算力平台,助力构建更加开放、繁荣的国产AI生态。
2026-09-09 10:19 阅读量:348
GLM-5.3-Flash开源即适配,昆仑芯加速国产算力与大模型生态协同
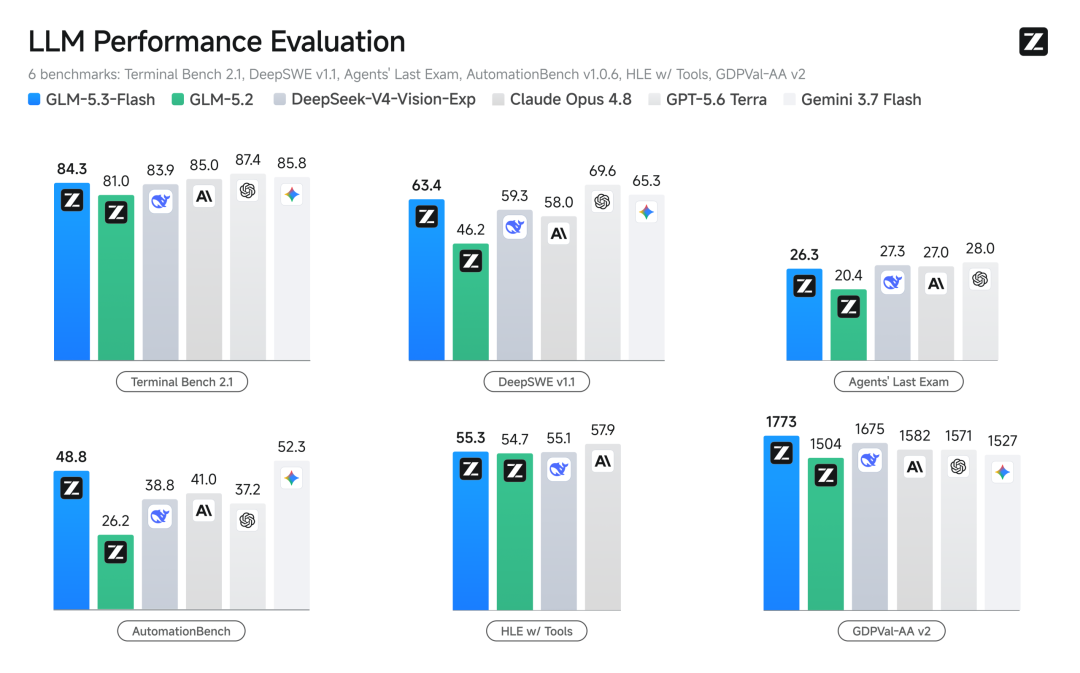
  8月26日,智谱正式发布并开源GLM系列的首个原生多模态模型GLM-5.3-Flash (320B-A18B)。模型开源当日,昆仑芯即完成对GLM-5.3-Flash的适配与联合精调,成为首批完成该模型适配的国产算力厂商之一,展现了面向前沿大模型的快速响应能力与生态兼容实力。近半年来,随着智谱持续推进GLM系列模型迭代,昆仑芯已完成对GLM系列多款模型的快速适配。此次快速适配不仅体现了昆仑芯面向前沿模型的Day 0响应能力,也进一步验证了国产算力支撑新一代大模型高效推理的能力。通过持续提升模型适配效率与优化软硬件协同能力,昆仑芯正加速推动前沿模型与国产算力生态协同,为大模型应用落地提供更加高效、敏捷的算力支持。  低成本高效推理,解锁大模型多场景应用  据介绍,GLM-5.3-Flash是GLM-5系列首个原生多模态模型。模型采用低成本架构,以320B总参数、18B激活参数实现高效推理,在保持模型能力的同时降低计算与服务成本。通过线性注意力与稀疏注意力相结合的混合架构,以及IndexPool等技术,模型进一步降低长上下文场景下的计算、显存和时延开销,支持最高1M上下文。  同时,GLM-5.3-Flash将视觉能力融入Coding流程,能够结合界面、渲染结果和交互反馈持续优化代码,覆盖前端开发、游戏构建、Blender 3D场景以及BUA、CUA驱动的真实环境操作等场景。此外,模型进一步拓展至Office、金融研究、专业文档等复杂任务,支持从分析研究到专业成果交付的完整工作流。  开源即适配,昆仑芯持续提升模型部署效率  随着国产大模型迭代速度不断加快,模型创新周期持续缩短,算力平台能否快速完成适配,正成为影响先进模型落地效率的重要因素。围绕智谱GLM系列模型演进,昆仑芯始终保持同步跟进,已完成GLM-4.7、GLM-5、GLM-5.1、GLM-5.2等多款模型的Day 0适配,不断提升模型从开源发布到国产算力部署及产业应用的响应效率。此次GLM-5.3-Flash开源后,昆仑芯第一时间完成模型适配与联合精调,实现对智谱最新模型的快速支持。这一快速适配能力,源于昆仑芯自研架构与长期深耕的软件栈。昆仑芯现已构建了覆盖底层驱动、开发工具SDK、专业算子库等核心环节的自研软件栈,持续提升算子覆盖广度与生态兼容深度,为模型快速迁移、高效部署与稳定运行提供坚实保障。依托完善的软件生态,昆仑芯进一步降低模型迁移与部署门槛,帮助开发者以更低成本、更高效率完成模型部署,加速AI应用创新。在本次GLM-5.3-Flash适配中,昆仑芯实现了模型精度无损迁移与高效部署,在保障稳定运行的同时充分释放硬件计算性能,降低模型部署门槛,缩短从开源发布到产业应用的落地周期。依托高效算力平台与自研软件栈优化能力,昆仑芯为GLM-5.3-Flash提供稳定、高效的国产算力支持,助力企业快速将前沿模型能力转化为实际业务价值。  “发布即适配”加速,模型与算力生态协同提速  在模型能力持续突破、创新周期不断缩短的背景下,模型厂商、算力平台、开发者与产业伙伴之间的协同效率,正成为推动AI技术规模化应用的重要因素。面对智谱GLM系列模型的持续升级,昆仑芯始终保持同步跟进,以更快的响应速度衔接模型创新与算力部署,推动主流模型更快进入实际应用场景。  面向未来,昆仑芯将继续深化与模型厂商、开发者及产业伙伴的合作,持续提升主流模型适配与部署能力,推动国产算力与模型生态高效协同,共同加速“国芯+国模”生态成熟,助力国产AI产业高质量发展。
2026-08-28 16:02 阅读量:446
昆仑芯联合蚂蚁密算打造国产GPU机密计算方案,夯实国产AI安全算力底座
近日,中国信息通信研究院泰尔终端实验室(以下简称“泰尔终端实验室”)正式发布国内首份面向通用 GPU TEE(可信执行环境)的专项系统检测报告。本次测评是国内首次针对通用GPU可信执行环境技术开展权威专业评测,围绕安全隔离、远程证明、密态大模型推理安全保护三大核心维度完成严苛验证。作为首批完成适配的国产AI算力平台之一,昆仑芯P800系列产品已全面兼容该GPU TEE方案,双方共同打造兼具高性能、高安全的国产AI可信计算解决方案,为企业级大模型部署提供更加安全可靠的算力底座。依托昆仑芯P800系列产品与蚂蚁密算通用GPU TEE HyperGPU技术,该方案无需更换现有硬件,即可为昆仑芯GPU平台赋予可信执行能力,实现模型权重、用户提示词、推理结果等敏感数据在GPU计算过程中的硬件级安全保护,覆盖安全隔离、远程证明、密态推理等关键能力,有效解决AI训练与推理过程中“数据在用即裸奔”的行业难题,为国产AI算力筑牢硬件级数据安全底座。该方案通过在昆仑芯P800系列产品的AI服务器部署由蚂蚁密算团队提供的整套GPU TEE,即可为昆仑芯GPU平台赋予可信执行能力,整个P800的软件栈可以完整运行在蚂蚁密算团队提供的GPU TEE中实现正常业务操作。根据泰尔系统实验室测试结果,在开启全链路密态保护及最高级别安全防护的情况下,该方案推理性能损耗低于2%,实现安全能力与计算性能兼顾。基于昆仑芯领先的AI算力性能和完备的软件生态,结合蚂蚁密算机密计算技术,双方为数据敏感行业提供兼具高性能、高安全、自主可控的大模型基础设施解决方案。作为业界领先的AI计算芯片及软硬件系统供应商,昆仑芯科技始终坚持开放生态发展理念,持续完善芯片、集群系统和软件平台能力,已完成对国内主流模型的快速适配,并不断携手产业伙伴推动国产AI基础设施能力升级。此次与蚂蚁密算联合推进GPU可信执行环境落地,是昆仑芯在完善AI基础设施安全能力方面的重要实践,也进一步拓展了国产AI算力平台在机密计算领域的应用边界。未来,双方将围绕大模型训练、推理及多方协同计算等场景持续深化合作,加快国产算力可信执行环境在更多行业和应用场景中的落地,推动国产AI基础设施实现计算性能、安全可信与自主可控能力的协同提升,为大模型规模化应用提供更加坚实的安全算力底座。
2026-08-26 13:28 阅读量:514
  • 一周热料
  • 紧缺物料秒杀
型号 品牌 询价
TL431ACLPR Texas Instruments
BD71847AMWV-E2 ROHM Semiconductor
RB751G-40T2R ROHM Semiconductor
CDZVT2R20B ROHM Semiconductor
MC33074DR2G onsemi
型号 品牌 抢购
BP3621 ROHM Semiconductor
BU33JA2MNVX-CTL ROHM Semiconductor
STM32F429IGT6 STMicroelectronics
ESR03EZPJ151 ROHM Semiconductor
TPS63050YFFR Texas Instruments
IPZ40N04S5L4R8ATMA1 Infineon Technologies
热门标签
ROHM
Aavid
Averlogic
开发板
SUSUMU
NXP
PCB
传感器
半导体
相关百科
关于我们
AMEYA360微信服务号 AMEYA360微信服务号
AMEYA360商城(www.ameya360.com)上线于2011年,现 有超过3500家优质供应商,收录600万种产品型号数据,100 多万种元器件库存可供选购,产品覆盖MCU+存储器+电源芯 片+IGBT+MOS管+运放+射频蓝牙+传感器+电阻电容电感+ 连接器等多个领域,平台主营业务涵盖电子元器件现货销售、 BOM配单及提供产品配套资料等,为广大客户提供一站式购 销服务。

请输入下方图片中的验证码:

验证码