昆仑芯科技副总裁孙孝思:AI大模型的突破与创新需要算力基础设施

发布时间:2023-03-09 10:13
作者:Ameya360
来源:网络
阅读量:3265

  2022年是整个人工智能芯片行业充满挑战的一年,从业者们都感受到丝丝寒意。因为2022年不仅处于疫情的波动期中,国际形势还对整个人工智能产业带来了限制。然而进入2023年后,CHATGPT带来了一点暖意。CHATGPT可以说是迄今为止增长最快的消费应用程序,它不是一触即发的,而是基于其前三代,不断迭代产生的,直到今天的爆发。

  为什么如今有更多的人关注它,很多演讲人也不断提及它?因为CHATGPT带来了质的飞跃,超越了人类平均基准线。
昆仑芯科技副总裁孙孝思:AI大模型的突破与创新需要算力基础设施

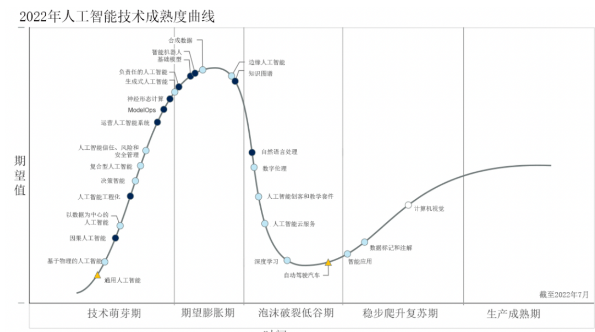
  来源:GARTNER2022年人工智能技术成熟度曲线

  GARTNER在2022年发布了一个人工智能技术成熟度曲线,生成式人工智能处于技术萌芽和期望的膨胀期,也就是说,技术从最初我们在人工智能的理解上,开始慢慢向发展阶段过渡,这对于人工智能产业中,无论是做芯片、框架,还是做算法的人来说,都是一个极大的利好。

  01

  CHATGPT背后:

  算法、数据、算力三要素共振

  CHATGPT背后是什么?今天在场的郑纬民院士以及其他很多演讲者此前都有提到,根源在于算法、数据、算力三个要素之间的共振。

  算力方面,现在的CHATGPT是基于GPT3.5的大模型,在训练中使用了微软专门建设的AI计算系统,由1万个业界主流GPU组成的高性能网络集群,总算力消耗约3640 PF-DAYS。

  数据方面,GPT-2的数据量是40G,GPT3的数据量达到了45TB,这是一个大规模的数据量的跃升。

  算法方面,如前所述,它不是一蹴而就的,而是经过了几次迭代。

  这几年的数据、算法、算力方面都有非常大的变化。中国在数据方面非常有优势,我们有场景、有大量的数据。在算法方面,实现了跨模态的融合,包括语音、图文、视频等很多方向。算力供给方面,这几年全国各地都在推进算力建设,我们相信未来国内的应用会有很大的变化和增长。

  02

  AI大模型应用突破与技术创新:

  目前,国内有很多关于CHATGPT的研究,除了清华大学的“八卦炉”,还有阿里、腾讯的大模型,也包括百度。百度即将在3月16日发布的文心一言,背后其实也是大参数、大算力、大数据量。我们可以意识到,未来的应用突破和技术创新需要算力的基础设施。

  也许有人会问,下一个CHATGPT到底是什么?现在火爆的聊天、语音生成属于CHATGPT的范畴,但是未来会有很多的衍生物,例如文本生成、视频生成、音频生成、虚拟人生成方面。

  我们认为,未来会有几个依托于算力的大场景,其中一大场景就是自动驾驶。自动驾驶场景中,模型感知和场景库的仿真训练需要上千P的算力。目前,我们跟新能源头部车企有很多紧密联动,我们发现自动驾驶的发展需要算力来提供技术的突破和跃升。生物医药也对算力有很强的需求,我们也看到了人工智能发挥的作用,例如ALPHAFOLD已预测出全球几乎所有已知蛋白质结构。

  可能有很多算力基础设施商都在思考,建了那么多数据中心、算力中心,到底应用在哪些地方?我们回顾一下,北京最早的京藏高速,我们叫G6,建设初期一辆车都没有,但今天却是北京堵车最严重的一条高速公路。还有4G网络,最早国家在建设4G网络的时候,大家都认为3G网络已经足够用了,为什么要上4G?为什么要投入那么大的成本?但今天看来,也有人觉得4G网络卡。所以我们要重新理解算力,它其实是信息基础设施。

  算力网络的布局会很大程度激发人工智能的应用和技术创新。

  目前,算力成本普遍偏高,有很多中小企业的创新在一定程度上受到了成本的影响。例如,复旦大学做MOSS大模型的时候,也会考虑到学校、科研机构是否能够承担起大模型的训练。

  从政府、国家、行业的角度看,我们怎么能够实现算力的普惠?我相信2023年之后,在算力建设过程当中,除了我们这些企业,各方都将更多参与进来,这样才能够真正实现普惠,大大降低企业使用算力的成本。

  03

  场景、数据驱动下人工智能芯片的挑战

  算力对于场景的创新很重要。但是作为一个人工智能芯片的企业,我们也充分认识到,在市场需求打开的情况下,整个人工智能芯片也面临巨大挑战。
昆仑芯科技副总裁孙孝思:AI大模型的突破与创新需要算力基础设施

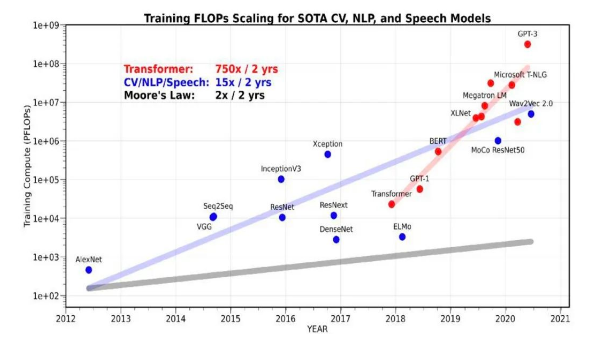
  资料来源:《AI算力的阿喀琉斯之踵:内存墙》

  上图中,蓝线上是视频、自然语言处理和语音模型,其模型运算量平均每两年翻15倍;红线上TRANSFORMER的这种神经网络大模型,其模型运算量平均每两年会翻750倍;而灰线则标志摩尔定律下内存硬件大小的增长,平均每两年翻2倍。

  因此,可以由此想到两点:第一,未来摩尔定律会面临失效的风险;第二,要考虑内存墙的存在。对于整个芯片行业的发展来说,如何在未来的演进中找到突破口,其实CHIPLET是一个方向。可见,先进封装技术对于AI芯片行业将是一个重要的助推器。这几年,昆仑芯科技也在这方面做了很多基础研发。

  人工智能芯片离不开工程实现,为什么这么说?因为它毕竟是一个产品,想要在行业跟场景紧密结合,必须解决三个问题:通用性、易用性和性价比。

  企业、高校可以在基础科研上做很多的探索,人工智能芯片企业同时必须要考虑到它的应用、商业化落地等问题。如何去解决通用性、易用性和性价比的问题,是人工智能芯片厂商共同面临的挑战。

  芯片不是一个标品。在硬件层面,我们可以达到业界主流GPU产品差不多的性能指标,但在软件层面上差距较大。从同行的角度来看,我们需要自己的软件栈去解决通用性问题,也要给开发者提供更好的软件栈,让开发者可以基于国内的人工智能芯片做开发。

  04

  结语

  昆仑芯科技前身是百度智能芯片及架构部,虽成立不久,却已有十余年的芯片研发经验。基于百度丰富的AI场景积累,昆仑芯产品实现了与场景需求、客户需求的紧密耦合。

  基于对场景的深刻理解,昆仑芯与智能产业的上下游携手,逐步构建起软硬一体化的AI芯片生态。目前,昆仑芯产品已与百度飞桨、PYTORCH、TENSORFLOW等主流框架和服务器完成适配。

  完善解决方案才能够真正赋能产业。昆仑芯两代芯片产品均已实现量产,并凭借其强大通用性、易用性和高性能,广泛部署在智慧金融、智慧交通、智慧工业等领域,不断提供更优秀、更高效的解决方案,为客户提供更好的服务。

  未来,我们希望可以和在座的同行们一起共筑合力,赋能芯片产品与应用场景更紧密结合,在人工智能产业发展中构建更加繁荣的生态系统。


(备注:文章来源于网络,信息仅供参考,不代表本网站观点,如有侵权请联系删除!)

在线留言询价

相关阅读
极速响应,生态共建|昆仑芯完成MiniMax M3.1 Flash模型Day 0适配
  今日,MiniMax M3.1 Flash模型权重正式释放。昆仑芯同步完成该模型的Day 0适配,成为首批完成该模型适配的国产算力厂商之一,展现了面向前沿大模型的快速响应能力与生态兼容实力。据悉,MiniMax M3.1 Flash是MiniMax推出的新一代Flash模型,重点面向复杂Agent任务、软件开发、Computer Use及网络安全等场景。在复杂任务处理方面,模型支持多步骤规划、工具调用与企业工作流执行;在软件开发方面,提升了对代码理解、功能开发、问题修复及测试验证等任务的支持能力;在计算机操作方面,进一步强化了跨应用交互与连续任务执行能力。昆仑芯持续跟进MiniMax系列模型的技术演进,深化芯模协同,已先后完成MiniMax M2.7、M3、H3等多款模型的Day 0适配。此次MiniMax M3.1 Flash模型权重开放后,昆仑芯团队第一时间开展适配,围绕关键算子、软硬件协同及多卡通信等环节进行优化,并完成模型部署验证,为用户在昆仑芯国产算力平台上开展模型部署、运行测试与应用探索提供支持,助力模型实现权重开放后快速部署。  深化软硬件协同,完善模型适配能力  随着大模型架构持续演进、应用场景不断拓展,算力平台不仅需要满足不同模型的运行要求,还需要通过软件栈适配、算子优化与软硬件协同,提升模型部署效率与运行表现,为模型从开发验证走向实际应用提供支撑。围绕这一需求,昆仑芯持续完善自研软件栈,完整覆盖从底层驱动、开发工具SDK到专业库等核心组件,并围绕主流模型架构与AI开发生态开展适配和优化,为模型迁移、性能调优及规模化部署提供基础支撑。依托自研软件栈与软硬件协同优化能力,昆仑芯能够针对不同模型架构及其运行特点开展适配与调优,提升模型在国产算力平台上的兼容性与部署效率,缩短模型从发布到平台落地的周期,为开发者开展模型开发、部署验证及后续优化提供便利。  持续拓展模型覆盖,推动算力与开源生态协同  开源模型生态加速发展,模型架构、开发框架与应用需求日益多样化。算力平台对主流模型及开发框架的兼容程度、适配效率和工程化支持能力,正成为连接模型创新与应用落地的重要环节。昆仑芯积极跟进主流开源模型及相关技术发展,持续推进模型适配与性能优化,适配范围已覆盖文本、多模态、图像生成等多类模型,不断拓展对不同模型架构及应用场景的支持能力。从模型发布后的快速响应,到面向不同架构的深度适配与优化,昆仑芯持续完善模型适配体系,推动国产算力平台与主流开源模型及开发框架有效衔接,为企业和开发者提供更加丰富的模型部署与应用选择。未来,昆仑芯将继续紧跟前沿大模型发展趋势,深化与模型厂商、开源社区及生态伙伴的协同合作,持续提升模型适配效率、平台兼容能力与工程化水平,推动国产算力与大模型生态协同发展,为人工智能应用创新与落地提供坚实的算力支撑。
2026-10-23 11:12 阅读量:274
昆仑芯与openEuler完成兼容性互认证,持续拓展国产算力生态协同
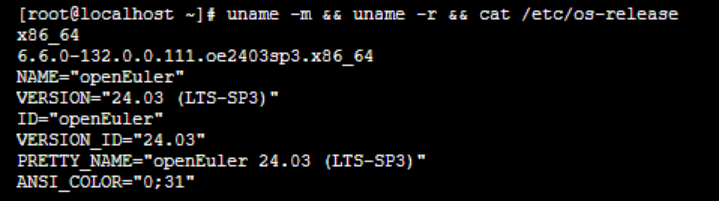
  近日,OpenAtom openEuler(简称 “openEuler” 或 “开源欧拉”)与昆仑芯P800系列产品完成兼容性互认证。双方围绕系统与设备识别、驱动及软件环境、链路与设备互联等关键环节开展验证,共七项子测试全部通过,验证了昆仑芯P800产品与openEuler在基础软硬件运行环境层面的兼容性,为国产算力产品在开源操作系统中的部署应用提供实践支撑。  此次认证是昆仑芯持续推进主流软硬件生态适配、深化生态协同的又一实践。通过与开源操作系统开展兼容性验证,进一步夯实算力产品与基础软件环境之间的协同基础,为后续开展AI框架适配、模型部署及业务验证创造条件。  深化软硬件适配,推动算力生态协同发展  随着AI算力应用不断拓展,算力产品的实际落地不仅依赖硬件能力,也需要操作系统、驱动、软件环境及设备互联等基础设施的协同支撑。软硬件兼容性是保障算力平台稳定部署和应用运行的重要基础。  本次兼容性互认证围绕系统识别、软件环境部署及链路互联等环节展开,重点验证openEuler对昆仑芯P800产品的识别能力、驱动与SDK部署情况,以及主机与设备、设备与设备之间的链路及互联能力。  测试结果显示,openEuler系统能够正确识别昆仑芯P800,驱动与SDK部署顺利,设备状态正常,设备互联相关测试均达到预期,七项子测试全部通过。  测试首先记录了操作系统基础信息,确认openEuler运行环境可用:  驱动安装完成后,系统可正确识别昆仑芯P800,并确认设备已绑定对应内核驱动、设备状态正常:  本轮验证覆盖基础运行环境中的多个关键环节,进一步打通国产AI加速卡与开源操作系统之间的软硬件协同通路,为算力产品融入多元化技术生态、拓展应用场景提供实践参考。  持续拓展主流生态适配,完善国产AI软硬件协同体系  人工智能产业的快速发展,正在推动算力生态从单一硬件能力竞争,向芯片、操作系统、AI框架、模型及应用等多层次协同演进。完善的软硬件生态适配能力,是降低用户部署门槛、提升算力应用效率、推动国产算力规模化落地的重要支撑。  围绕AI算力生态建设,昆仑芯持续推进与主流软硬件生态的适配与协作,现已构建覆盖基础软件、AI框架、模型及应用场景的完善的国产AI软硬件生态圈。在基础软件生态层面,昆仑芯积极推进与主流操作系统及相关软件环境的兼容验证,持续夯实算力产品的基础运行环境;在AI框架与模型生态层面,围绕主流框架及大模型开展适配、优化与部署验证,推动模型能力在昆仑芯算力平台上的应用;同时,通过与生态伙伴开展联合适配与技术协作,提升软硬件协同效率,促进适配成果向更多业务场景延伸。目前,昆仑芯已围绕多类主流软硬件生态开展适配与协同实践,持续拓展生态合作范围,推动算力能力与上层软件、模型及应用之间的衔接。  此次与openEuler完成兼容性互认证,是昆仑芯持续拓展主流软硬件生态适配范围的又一实践。通过基础运行环境验证,进一步夯实了昆仑芯算力产品与开源操作系统之间的协同基础,也为后续开展更深层次的软件适配与业务验证创造了条件。  未来,昆仑芯将持续加强与主流操作系统、AI框架、模型生态及产业伙伴的合作,推进软硬件适配成果积累与生态能力建设,逐步完善从底层运行环境到上层模型应用的协同体系,推动国产算力与开放软件生态深度融合,为用户提供更加开放、便捷、高效的算力应用环境,助力人工智能产业创新发展。
2026-10-21 09:52 阅读量:284
深化芯模协同,共筑开放AI生态|昆仑芯完成阶跃星辰Step 5 Preview模型Day 0适配
  今日,基础大模型公司阶跃星辰正式开源新一代旗舰基座模型Step 5 Preview。模型开源当日,昆仑芯即完成对Step 5 Preview的适配与联合精调,成为首批完成该模型适配的国产算力厂商之一,展现了面向前沿大模型的快速响应能力与生态兼容实力。据悉,Step 5 Preview模型面向长程Agent任务设计,采用稀疏MoE架构,总参数量达600B,每个Token仅激活27B参数,支持100万Token上下文窗口,并原生支持文本与视觉输入,在AI编程、软件工程、专业知识工作、金融等场景中表现突出。近期,Step 5 Preview在OpenRouter周调用量和日调用量榜单中均位居全球第二。此次适配过程中,昆仑芯围绕Step 5 Preview的模型架构与关键算子开展针对性优化,结合其超长上下文、稀疏MoE等技术特点,通过底层算子优化与软硬件协同,提升模型运行效率、稳定性与资源利用水平,为复杂智能体任务提供高效算力支持。  软硬协同优化,提升模型适配与部署效率  此次与阶跃星辰围绕Step 5 Preview开展Day 0适配,是昆仑芯深化主流模型生态合作、提升芯模协同能力的又一实践。快速适配能力的背后,是昆仑芯长期积累的软件生态基础。  昆仑芯持续完善自研软件栈,构建覆盖底层驱动、开发工具SDK、专业库等核心组件的软件体系,并围绕主流模型架构与AI开发生态开展适配和优化,为模型迁移、性能调优及规模化部署提供软件支撑。  依托成熟的软件栈与软硬件协同优化能力,昆仑芯能够面向不同模型架构及应用需求快速开展适配,降低模型迁移与部署成本,缩短模型从发布到算力平台落地的周期。在保障模型稳定运行的同时,进一步提升开发者的模型开发与应用部署效率,为前沿大模型快速进入实际应用提供高效、灵活的算力环境。  持续保持Day 0适配,构建开放协同的模型生态  随着大模型迭代速度不断加快,模型从发布到应用落地的周期不断缩短,对算力平台的快速适配能力与生态兼容性提出了更高要求。除了及时响应单个模型的发布,算力平台还需要不断拓展模型适配范围,满足不同开发者及应用场景的多样化需求。  近一年来,昆仑芯紧跟主流开源模型发展,已完成对头部厂商40余款旗舰模型的快速适配,覆盖文本、多模态、图像生成等多个方向,推动“发布即适配”逐步成为常态。在持续提升模型适配效率的同时,昆仑芯不断丰富平台支持的模型类型,拓展生态兼容边界,为开发者提供更广泛的模型选择与算力支持,助力前沿模型加速落地应用。  面向未来,昆仑芯将进一步加强与国产模型企业及生态伙伴的合作,以“国芯+国模”协同发展为契机,强化对前沿模型架构、算法及应用场景的适配能力,通过软硬件协同优化提升模型与算力平台的适配效率,推动更多前沿模型高效运行于国产算力平台,共建开放协同的国产AI生态,助力AI应用加速走向千行百业。
2026-10-15 13:29 阅读量:305
昆仑芯完成RLinf适配验证,拓展具身智能强化学习开源生态
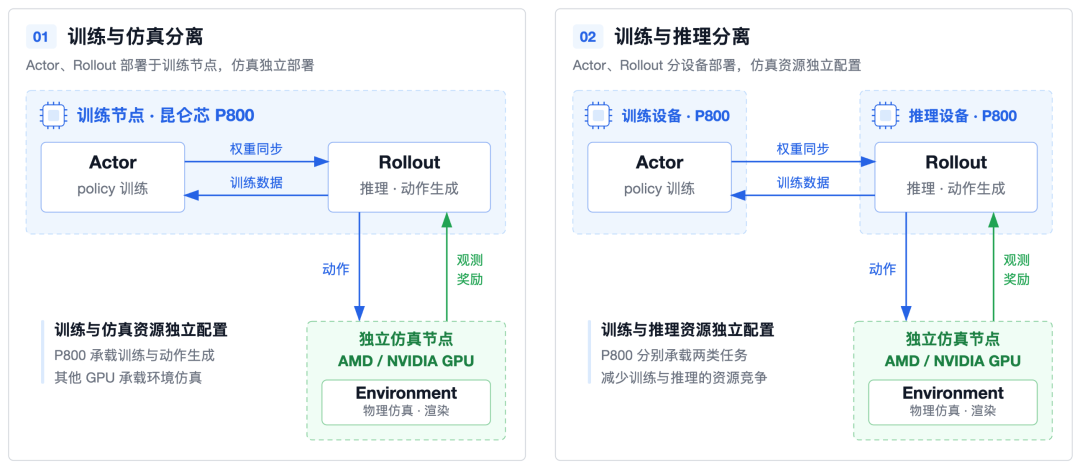
  随着具身智能加速从技术探索走向规模化研发,强化学习正在成为提升机器人自主决策与任务执行能力的重要技术路径。与此同时,具身智能研发对算力平台的兼容性、分布式训练能力以及训练、仿真、推理协同提出了更高要求。  近日,昆仑芯完成具身智能强化学习框架RLinf适配验证,覆盖单节点训练、多节点协同、训练与仿真分离、训练与推理分离等典型场景,并完成Pi系列模型在LIBERO任务上的训练复现,进一步拓展昆仑芯在具身智能强化学习领域的开源生态支持。  接入主流开源框架,拓展应用支持  RLinf是面向具身智能的“仿训推一体化”大规模强化学习框架,由清华大学、无问芯穹联合发起,于2025年9月开源。框架面向具身智能与智能体场景,提供覆盖仿真、训练和推理的统一强化学习基础设施,旨在打通渲染、训练、推理等环节,为开发者提供从仿真环境交互到策略更新的完整强化学习流程,目前已在机器人等相关场景中开展应用。  此次适配中,昆仑芯基于RLinf模块化的硬件接口设计,通过标准插件方式完成Kunlunxin XPU后端接入,无需修改框架既有实现,即可将昆仑芯算力纳入RLinf运行体系,进一步打通设备管理、任务调度与分布式通信等关键环节。  在设备管理与任务调度方面,昆仑芯完成Kunlunxin XPU设备发现、资源配置及Ray调度适配,确保训练任务能够准确使用实际分配的算力资源;在分布式通信方面,以XCCL作为通信后端,支持AllReduce、AllGather等多卡集合通信,打通单节点及多节点强化学习任务的运行基础。  基于上述适配,昆仑芯P800能够在RLinf框架下开展单节点、多节点以及训练、仿真、推理分离等多种运行模式验证,为具身智能强化学习任务提供更加灵活的国产算力支持。  覆盖多种部署模式,提升资源调度灵活性  具身强化学习涵盖训练、仿真与推理等多个环节,对算力资源的配置方式提出了更高要求。基于RLinf,昆仑芯P800完成多种部署模式的适配验证。  其中,在训练与仿真分离模式下,Actor、Rollout部署于训练节点,Environment部署于独立仿真节点,实现训练与仿真资源的独立配置;在训练与推理分离模式下,策略训练与动作生成部署于不同设备,减少不同任务之间的资源竞争。  通过灵活的部署方式,昆仑芯P800进一步拓展了具身强化学习场景下的算力组织方式,为不同规模任务提供更加灵活的资源配置能力。  完成Pi 0.5适配验证,验证具身强化学习应用能力  在实际任务验证中,昆仑芯P800已完成LIBERO Spatial、Object和Goal等任务配置的适配验证。其中,Pi 0.5相关配置覆盖单节点8卡与双节点16卡环境,完成从单节点训练到多节点协同的运行验证。  在libero_spatial_grpo_openpi_pi05配置下,昆仑芯P800完成Pi 0.5模型在LIBERO Spatial任务上的强化学习训练与仿真评测。测试结果显示,在第70个训练step,模型任务成功率达到99.77%,强化训练曲线整体与公开结果呈现相同趋势;相比强化学习训练前,训练后策略成功率提升12.27%。  从训练到仿真评测,昆仑芯P800已跑通基于RLinf的完整强化学习流程。开发者可以沿用RLinf现有开发方式,在昆仑芯平台完成模型训练、策略优化与任务评测,为进一步开展具身智能强化学习研究与应用提供算力支撑。  优化分布式通信,降低多节点同步开销  在具身强化学习任务中,模型权重需要在训练与Rollout等环节之间频繁传递,通信效率直接影响整体运行效率。针对多节点训练中的权重同步开销,基于P800平台进一步优化跨节点通信链路,通过引入混合通信方案提升权重传递效率。  测试结果显示,单节点首个step的权重同步耗时由14.710秒降至3.006秒,多节点首个step由299.0秒降至6.510秒;在后续训练step中,相比仅使用Gloo,混合通信方案仍可节省约40秒的权重同步时间。  上述结果表明,经过通信链路优化,昆仑芯P800能够有效降低多节点强化学习任务中的同步开销,为具身智能强化学习的分布式运行提供更高效的通信支撑。  持续完善开源生态,助力具身智能适配  此次RLinf适配,是昆仑芯持续推进软硬件协同、拓展开源生态的重要实践。  从基础软件、AI框架到模型与应用,昆仑芯持续推进与主流生态的适配、优化与验证,不断拓展算力平台的兼容范围。通过对主流AI框架、大模型及具身智能相关框架的持续适配,昆仑芯不断完善软硬件协同能力与开发环境,降低开发者在国产算力平台上的迁移与验证成本。  目前,昆仑芯已完成包括RLinf在内的强化学习系列框架适配,并推动相关支持贡献至社区主线。未来,昆仑芯将持续加强与开源社区、具身智能产业链及开发者生态的协同,持续拓展主流框架与模型适配,完善软硬件协同的开发环境和生态体系,推动更多模型、框架与应用在昆仑芯平台高效运行,为机器人企业、科研团队及开发者提供更加开放、兼容的国产算力支持。
2026-09-30 16:52 阅读量:343
  • 一周热料
  • 紧缺物料秒杀
型号 品牌 询价
RB751G-40T2R ROHM Semiconductor
TL431ACLPR Texas Instruments
MC33074DR2G onsemi
CDZVT2R20B ROHM Semiconductor
BD71847AMWV-E2 ROHM Semiconductor
型号 品牌 抢购
BU33JA2MNVX-CTL ROHM Semiconductor
BP3621 ROHM Semiconductor
ESR03EZPJ151 ROHM Semiconductor
TPS63050YFFR Texas Instruments
IPZ40N04S5L4R8ATMA1 Infineon Technologies
STM32F429IGT6 STMicroelectronics
热门标签
ROHM
Aavid
Averlogic
开发板
SUSUMU
NXP
PCB
传感器
半导体
相关百科
关于我们
AMEYA360微信服务号 AMEYA360微信服务号
AMEYA360商城(www.ameya360.com)上线于2011年,现 有超过3500家优质供应商,收录600万种产品型号数据,100 多万种元器件库存可供选购,产品覆盖MCU+存储器+电源芯 片+IGBT+MOS管+运放+射频蓝牙+传感器+电阻电容电感+ 连接器等多个领域,平台主营业务涵盖电子元器件现货销售、 BOM配单及提供产品配套资料等,为广大客户提供一站式购 销服务。

请输入下方图片中的验证码:

验证码