泰晶科技76.8MHz热敏晶振主力保供中兴豆包<span style='color:red'>AI</span>手机,与高通8850“芯振协同”护航智能体新时代
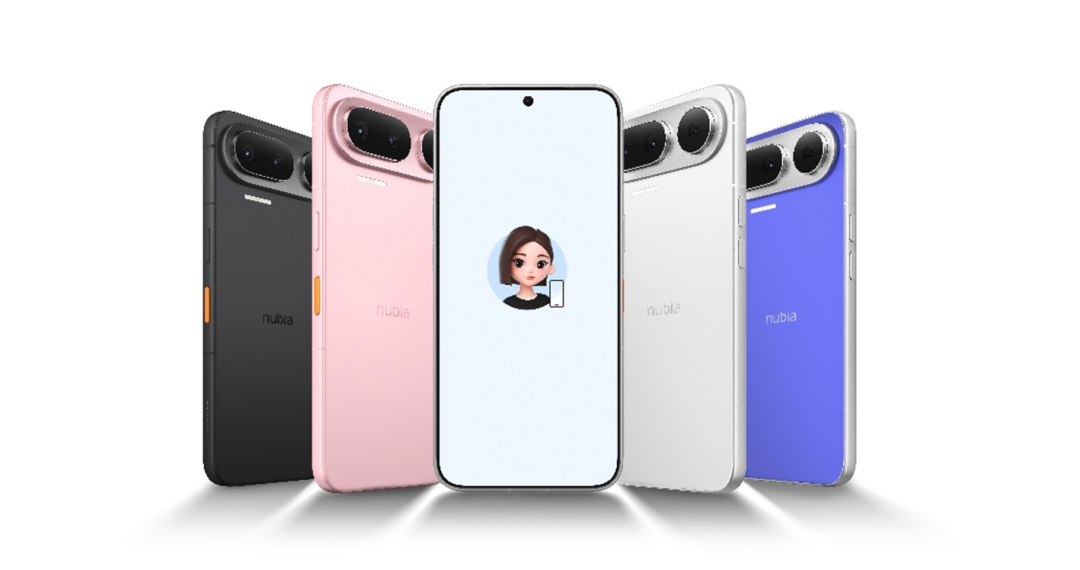
  9月16日,努比亚正式发布全新AI智能体手机努比亚NaviX Ultra。这款搭载第五代骁龙®8至尊版移动平台与豆包手机助手消费者版的旗舰终端,开启了智能手机AI交互体验的新时代,也被视为智能体体验在移动端规模化落地的重要里程碑。  在这款具有行业标杆意义的AI终端背后,泰晶科技自主研发的76.8MHz热敏晶体谐振器凭借卓越性能与高可靠性,与高通8850主控芯片深度搭配,成为其核心时钟频率器件的主力核心供应商。  高通主控 + 泰晶晶振:智能体时代的“芯振协同”  移动计算迎来关键转折点,智能体AI正在重塑人与终端的交互方式。而实现这一愿景,不仅需要强大的分布式计算能力,更需要整个产业生态的协同。  第五代骁龙8至尊版搭载定制的第三代Qualcomm Oryon CPU、全新架构Adreno GPU,以及面向智能体AI深度优化的Hexagon NPU。多核异构架构在高负载AI任务下协同工作,对参考时钟的精度、稳定性和瞬态响应提出了远超以往的要求。  晶振是主控芯片的“心跳”。76.8MHz作为主流5G移动平台常用的参考时钟频点,与高通8850的时钟架构直接匹配。泰晶科技76.8MHz热敏晶体谐振器围绕这类高频主控平台的参考时钟需求开发,为主控提供稳定、低抖动的系统时钟基准。二者搭配后,主控芯片在运行大模型推理、跨应用智能调度、多任务连续对话等场景时,可获得持续精准的时序支撑。  热敏感知 + 光刻自产:让AI算力在温变中“稳得住”  AI手机在运行大模型、处理复杂AI任务时,芯片负载急剧攀升。努比亚NaviX Ultra上的豆包手机助手需要实现多种方式快速唤醒、连续对话、多任务及跨APP操作等流畅体验。这意味着主控芯片自身温度可能快速变化,对参考时钟的瞬态稳定性提出更高要求。  泰晶科技76.8MHz热敏晶体谐振器在1.6×1.2mm封装内集成热敏电阻,可实时感知温度变化,并与外部补偿电路协同,对频率-温度特性进行动态修正。在-40℃~+85℃工作温区内,产品兼顾低迟滞、补偿重复性和频率稳定性,与高通8850主控形成“感知—补偿—稳定运行”的闭环协同。  产品采用泰晶科技自产的光刻晶片。光刻工艺相比传统研磨工艺,具有更高的频率精度、一致性以及更优的温度特性。低等效串联电阻(ESR)设计有助于改善起振裕量和运行稳定性,确保与主控芯片搭配时快速起振、稳定运行。1612微型封装可进一步节省主板空间,为AI手机内部更大容量的电池、更复杂的摄像头模组释放布局空间。  本次为中兴豆包AI手机供应高频时钟频率器件,体现了泰晶科技在高频、小尺寸热敏晶体产品开发、量产一致性和平台适配方面的持续积累。作为国内较早实现半导体光刻工艺规模化量产的晶振企业之一,泰晶科技长期聚焦高基频、小尺寸、高精度频控器件的技术研发与产能建设。加快高端频控器件在AI智能移动终端、汽车电子、AI智能穿戴等场景的应用,为全球客户提供稳定、可靠的时钟基准解决方案。
关键词:
发布时间:2026-09-18 09:56 阅读量:186 继续阅读>>
海凌科丨内存为什么涨了这么多?<span style='color:red'>AI</span>正在“吃掉”存储产能
  过去一年,DDR5内存价格持续攀升,大容量型号涨幅尤为明显。一套主流规格的双通道内存套条,售价从一年前的数百元人民币区间跃升至更高价位,部分型号价格上涨了数倍。32GB DDR5内存的价格涨幅同样显著。内存为什么涨了这么多?这次涨价并非简单的周期波动,而是存储芯片正在经历一场由AI驱动的结构性变革。  一、AI“吃掉”了内存  一台AI服务器的DRAM搭载量是传统通用服务器的数倍。AI大模型训练和推理需要海量数据吞吐,对内存的容量和带宽要求呈指数级攀升。  AI相关DRAM需求占比已显著提升。AI服务器所需的企业级内存占用了大量DRAM晶圆产能,并且这一比例还在上升。全球每年新增的内存产能中,算力数据中心占据了绝大部分。  AI对内存的需求不仅是“量大”,更是“质变”。大模型参数量正从千亿级迈向万亿级,存储容量需求不断膨胀;同时,GPU算力远超内存供给速度,计算单元大量时间在等待数据——这正是高带宽内存需求爆发的根本原因。  二、产能正在被重配  涨价的根源,在于高利润AI存储产品对通用DRAM产能的持续蚕食。  高带宽内存比标准DDR5消耗更多的晶圆面积,这种产能挤占效应使通用DRAM供给出现结构性短缺。  主要原厂已将大量资本支出倾斜到高利润AI存储产品,传统DDR4产能遭严重挤压。部分厂商已停止DDR4接单或调整产能结构,将资源向AI存储方向集中。  与此同时,大型科技企业通过长期协议提前锁定了大量高端产能。行业中有相当比例的服务器级DDR5产量已被超大规模云厂商通过长期供货协议提前锁定。  三、产能扩张的刚性约束  即便价格大幅上涨,产能扩张依然极为有限。新建晶圆厂从动工到量产需要数年时间,短期内无法形成有效供给。先进DRAM制程依赖EUV光刻机等高价值设备,一座现代化晶圆厂的投资规模巨大,建设周期漫长。  存储芯片产能存在刚性约束,短期内难以响应价格的上涨信号。这正是供给端结构调整需要较长时间的原因。  四、涨价的传导链条  AI对存储的虹吸效应,最终通过产业链层层传导至消费市场。存储芯片在整机成本中的权重显著上升,推高了终端设备的价格。部分终端厂商公开表示,内存涨价的趋势仍在持续。  PC、手机等消费电子市场因存储成本上升而面临价格压力,出货量预期受到影响。存储成本上升正在抑制部分消费需求。  存储芯片正从传统电子元器件转变为算力基础设施的核心资源,行业周期性波动的逻辑正在被AI长期需求重构。当AI算力集群持续扩大,存储带宽和容量成为关键瓶颈时,整个产业链的每一个环节,都身处这场变革之中。
关键词:
发布时间:2026-09-16 14:08 阅读量:221 继续阅读>>
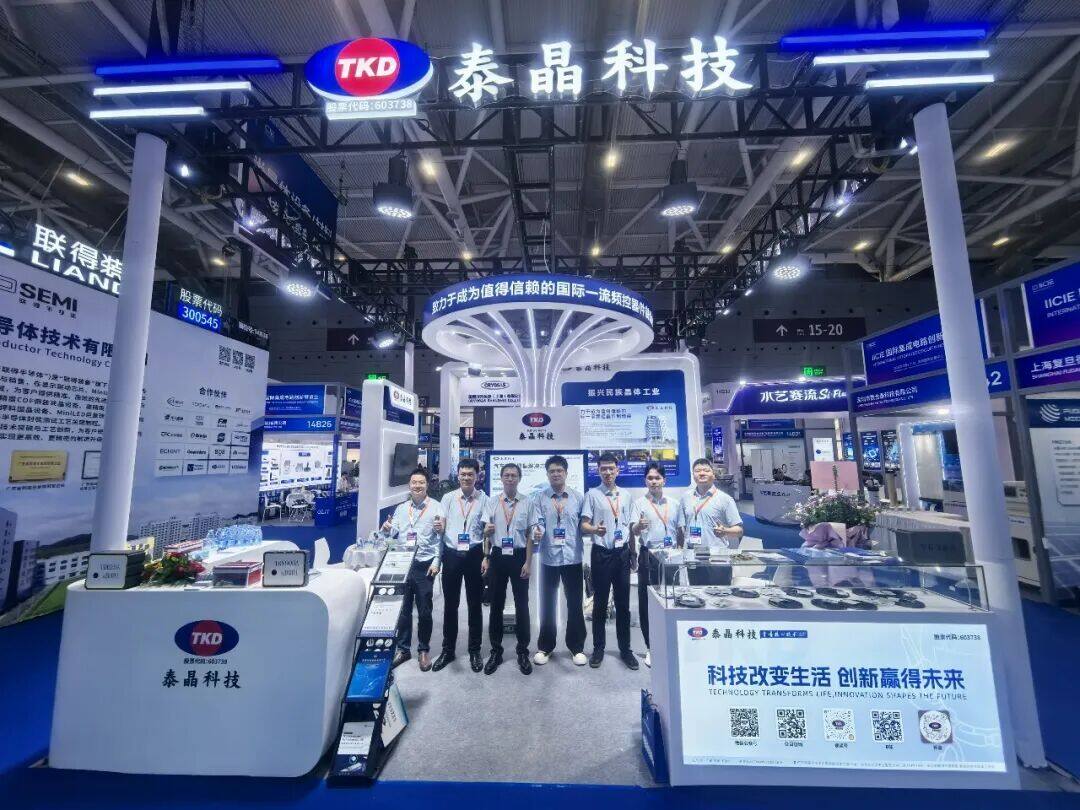
三展联动启幕:泰晶科技亮相行业盛会聚焦<span style='color:red'>AI</span>光模块与服务器新机遇
关键词:
发布时间:2026-09-14 11:56 阅读量:237 继续阅读>>
恩智浦丨加速端侧<span style='color:red'>AI</span>落地:立功科技推出i.MX 95开发套件!
  随着AI应用加速普及,端侧AI开发成为行业共同关注的焦点。立功科技基于恩智浦丰富的边缘智能产品组合,推出了基于i.MX 95的高性能Arm主控板Core-IMX95-S以及配套的评估套件,与性能高达40 eTOPS的Ara算力卡配合,可助力端侧AI快速落地。  i.MX 95应用处理器介绍  i.MX 95是恩智浦新一代高性能应用处理器家族,面向汽车、工业、网络、航空与物联网等边缘应用,将高性能实时计算、Arm Mali 3D图形、NXP eIQ Neutron NPU机器学习加速、高速连接以及EdgeLock安全集成于单芯片,并按照汽车ASIL-B、工业SIL-2功能安全标准开发,是恩智浦首款集成NPU与自研ISP的i.MX应用处理器。  i.MX 95主要性能  异构多核计算:6× Cortex-A55 + Cortex-M7/M33双实时域,覆盖应用、实时与安全负载;  边缘AI加速:eIQ Neutron N3-1024S NPU,高达8 eTOPS,支持NVIDIA TAO模型;  图形与多屏显示:Mali-G310 3D GPU + 独立2D GPU,4K超宽屏、三路独立显示;  机器视觉:自研ISP 500M像素/秒,多路摄像头与RGB-IR,覆盖工业与车载视觉;  高速网络连接:1× 万兆 + 2× 千兆以太网 (TSN/1588),2× PCIe Gen3扩展特;  安全与功能安全:EdgeLock安全域,安全启动/OTA,面向ASIL-B/SIL-2。  ▲图1:i.MX 95处理器主要特性与框图  i.MX 95典型目标应用  汽车:连接域控、车载信息娱乐、环视监测  工业:网关、工厂自动化、机器视觉、HMI  医疗:泵/呼吸机/临床监护  i.MX 95高性能Arm主控板  Core-IMX95-S是立功科技基于i.MX 95处理器开发的一款高性能Arm主控板,主控采用6核Arm Cortex-A55 @1.8GHz处理器,该处理器支持3D/2D GPU、各种图像及视频编解码器,具备强大的图形处理与NPU功能;同时,支持MIPI-DSI及LVDS显示接口、支持MIPI-CSI及8路虚拟通道,具有丰富的音视频功能。i.MX 95还具有PCIe、USB3.0/2.0、千兆网口、万兆网等众多通讯接口。  该主控板集成DDR、eMMC、看门狗及电源,采用邮票孔加LGA的超小封装模式,是一款高性能ARM主控板。  ▲图2:Core-IMX95-S主控板  ▲表1:Core-IMX95-S主控板资源  ▲表2:Core-IMX95-S主控板对外资源  i.MX95高性能主控板评估套件  Smart-IMX95-S是基于Core-IMX95-S设计的高性能评估板,采用邮票孔主控板加底板的形态,支持MIPI-DSI/LVDS显示接口,支持Wi-Fi/4G无线通讯模组,具有MIPI-CSI接口、两路千兆网口、一路万兆以太网、USB 3.0、USB 2.0、SD卡、PCIe等接口。  Smart-IMX95-S评估套件支持Linux 6.12 / Android 16系统,广泛应用于智能家居、汽车电子、城市和工业4.0等场景。  ▲图4:Smart-IMX95-S评估板顶层示意图  ▲图5:Smart-IMX95-S评估板底层示意图  ▲表3:Smart-IMX95-S评估套件底板资源  Ara算力卡 + i.MX 95评估套件  Ara系列芯片是恩智浦推出的高性能、低功耗独立神经网络处理器,专为边缘端生成式AI与大语言模型加速设计。它支持高达40 eTOPS算力,兼容TensorFlow、PyTorch、ONNX框架,搭载安全启动与信任根处理器,典型功耗仅6.5W。  Ara系列可实时运行AI模型,多模型切换无性能损耗,适配工业自动化、智能座舱、智能家居等场景。其提供M.2与USB模块,搭配专属SDK简化部署,助力边缘AI设备快速落地。  ▲图6:NXP Ara算力卡与i.MX 95评估套件  性能  高达40 eTOPS  6.5W典型功耗  17mm x 17mm封装,625Ball,P0.65mm,工业级芯片 (-40℃-85℃)  接口  PCIe:4 lane Gen 4,x1/x2/x4模式,16Gbps per lane  USB:3.2 Gen2,10Gbps  外接存储  最高可接16GB内存,单片64位或两片32位,支持LPDDR4/4x  1-2GB用于视觉应用,4/8/16G用于通用AI运用  软件  通过可扩展编译器、算子支持及可编程数据流,实现AI模型的优化执行  灵活的量化技术,以及与 eIQ 人工智能软件的集成  ▲图7:i.MX 95 + Ara端侧AI解决方案
关键词:
发布时间:2026-09-14 10:34 阅读量:222 继续阅读>>
无惧<span style='color:red'>AI</span>服务器突发负载——松下双电层电容器EDLC中国首发!
关键词:
发布时间:2026-09-14 10:07 阅读量:221 继续阅读>>
广和通战略投资烨知心,深化端侧<span style='color:red'>AI</span>生态布局
  近日,广和通完成对烨知心科技(Yeats AI)的战略投资。目前,烨知心已获得蚂蚁集团、中科创星、深创投、TCL创投、和利资本、九合创投、同歌创投、艾为电子、国开科创、朝晖资本等知名产业方及头部VC的联合支持。  烨知心专注于端侧AI计算,聚焦NPU架构及软硬件协同。此次投资将进一步加强广和通与上游端侧算力伙伴的产业协同,持续完善面向AI终端的生态布局。  端侧AI迈向产品化  随着多模态、Agent等能力持续向终端侧延伸,AI手机、AI PC、智能眼镜、机器人等新一代终端加快智能化演进,端侧AI正进一步从模型部署走向产品化应用。  弗若斯特沙利文预测,2029年中国端侧AI市场规模将达3077亿元,五年复合增长率39.9%。快速增长的市场背后,功耗、性能与成本的平衡,仍是规模化落地需要解决的核心问题。  尤其在智能眼镜、可穿戴设备等对体积、散热和续航高度敏感的新兴终端中,芯片能效比直接影响终端的计算性能、续航表现与实际使用体验。  作为面向AI计算优化的重要架构,NPU能够提升端侧计算任务的处理效率与能效表现。随着更多模型向终端侧部署,高能效计算与面向不同模型、产品形态的适配能力,正成为端侧AI规模化落地的重要技术基础。  布局端侧算力生态  烨知心创始团队曾任职于苹果AI加速平台——Apple Neural Engine团队,公司专注于下一代AI Native硬件的极致能效推理场景,打造新一代统一生态的通用计算平台,为Agentic和Physical AI下不同场景提供跨终端平台的统一软硬件解决方案,实现架构+硬件+软件协同开发。  “端侧AI走向产品化,需要底层算力与终端需求更紧密结合。”烨知心相关负责人表示,“广和通在智能模组、终端客户及行业应用方面的积累,为端侧算力技术更快进入实际产品提供了良好基础。”  广和通高级副总裁、董秘陈仕江 表示:“此次投资是广和通端侧AI全栈布局的关键落子。烨知心在NPU架构及端侧计算方面的积累,与广和通面向智能终端的产品布局形成互补,将进一步完善‘算力底座—智能终端—场景应用’的协同链路。”  面向AI终端加速演进,广和通将以无线通信与人工智能为技术底座,持续链接上下游优质伙伴,推动更多智能能力向终端与场景落地,加速千行百业从“万物互联”迈向“万物智联”。
关键词:
发布时间:2026-09-11 11:01 阅读量:251 继续阅读>>
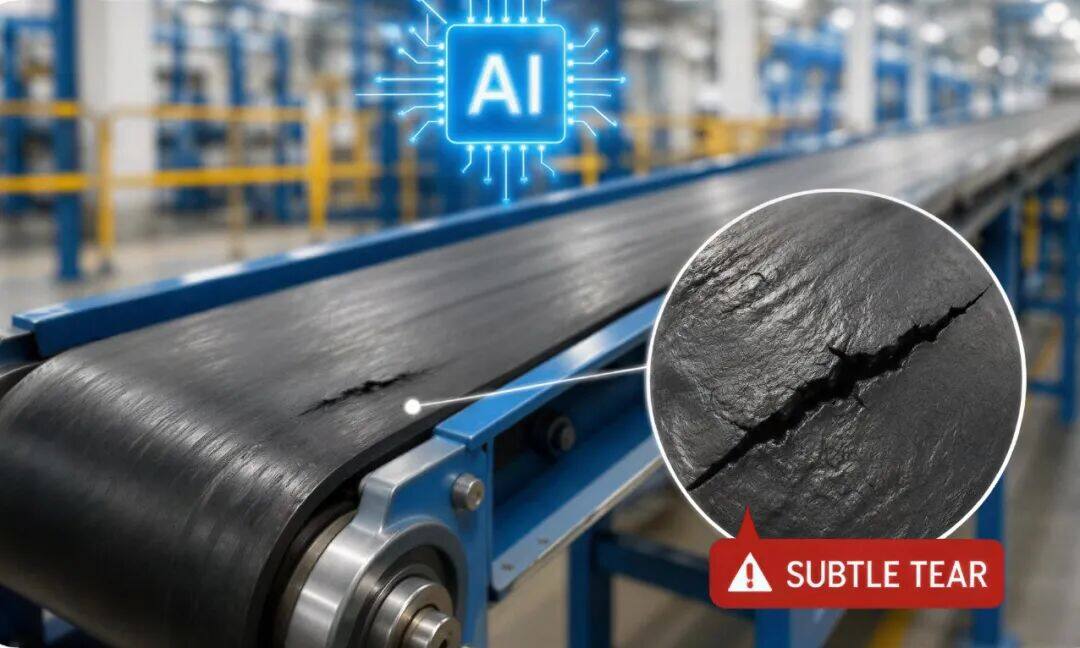
瑞萨丨重塑皮带监测技术:<span style='color:red'>AI</span>如何在故障发生前检出破损
  在工业电机驱动系统中,皮带扮演着重要的作用——用于实现旋转部件之间平稳、高效的机械动力传输。这些组件连接着两根轴,一根由电机驱动,另一根由皮带驱动,共同构成了一个可靠的皮带驱动系统,适用于多种工业场景。  皮带因其高功率传输效率、高性价比以及易于安装和更换的特点,一直都是工程师的首选。它们支持各种形状、材料和性能特点,支持多样化的机械运动和系统架构。  然而,正如所有机械组件一样,皮带也会随时间逐渐退化。持续运转使它们遭受疲劳、撕裂和磨损的影响,并且常会随着振动、过载和恶劣的环境条件而加重。即使是细小的破损也可能会引发严重的后果,包括性能下降、振动加剧、相邻组件磨损加快,在更加严重的情况下还会导致皮带意外故障,致使整个生产线中断。  皮带撕裂问题在系统尚在运转时难以检出,因此容易导致意外停工和代价高昂的维护成本。然而,一种基于AI的方法无需额外的外部传感器即可准确检出皮带破损。这种方法令工程师能够构建出智能化程度和成本效益更高的监测系统,使工业系统保持最佳运行状态。  图1:皮带存在明显撕裂损伤  图2:皮带状况良好  如上图所示,我们对两根皮带进行了对比:  一根出现了细小的结构性缺陷(可见的微小撕裂)  一根处于正常工作状态,无明显破损  在下一节中,为展现该方法的准确性和有效性,我们将展示这种基于AI的方法如何成功检测到这种细微的缺陷,并呈现相关结果。  如何检测皮带破损?  为了评估检测方法,我们使用两根皮带搭建了一个可控制的测试台:一根状况良好,另一根出现了明显撕裂。每根皮带分别安装在一个双轴系统上。  主轴由低压无刷直流(BLDC)电机驱动,该电机则由瑞萨电子的RA6T2电机控制套件供电。这个套件包含了一块RA6T2电机控制CPU板和一块低压电机控制逆变器板  副轴完全由皮带驱动  我们采用这种配置,搭建出一个精确可靠的平台,用于控制电机和采集数据。  图3:双皮带受控测试台架搭建示意图  我们使用正常皮带收集了基准数据,随后使用受损皮带重复了该流程。我们采用完全无传感器的方法,收集了逆变器电压和电流反馈数据,随后使用它们训练了AI模型以检测皮带破损。  数据集收集和AI模型训练  我们将瑞萨电子的Reality AI Tools®云平台和数据存储工具相结合,并通过e² studio中的Reality AI™ Utilities进行集成,从而构建出了可靠、高性能的检测模型工作流。这一工作流具有两大优势:  高效的数据集准备能力,包括信号可视化、噪声识别和自动数据集拆分  精简的环境,用于训练、优化和微调AI模型,从而实现高准确度和极小的内存占用  数据集被分为了两类:  正常皮带类:来自完好皮带的数据  受损皮带类:来自撕裂皮带的数据  完成训练后,我们借助独立数据集进行了交叉验证,以确保模型的稳健性和泛化能力。这一步确保最终模型的尺寸和计算足迹保持在适合嵌入式部署的范围内,同时不影响其准确度。  RAM:9KB  ROM:4.8KB  交叉验证准确度:98%  实际工况验证  为了验证模型性能,我们搭建了一个实体测试台,并在两种不同的运行条件下进行了测试。  冷启动测试:在环境电机温度下进行短暂运转  热稳定性测试:随着电机温度升高进行长时间运转  在两种条件下的大量测试均证实,模型在实际运行环境中具有一致的检测性能。  下图展示了该模型在各条件下的性能表现:  左图:冷启动性能  右图:在温度升高时的稳态性能  总结  工业皮带破损可能会引发意外停工,降低可靠性,甚至带来高昂的维护成本。这种采用AI技术的无传感器检测方法无需额外传感器,即可及早识别出皮带撕裂问题,从而有效解决了这一难题。因此,工程师可以从定期检查转向持续工况监测,并在问题干扰生产前及时采取措施。通过协助工程师在更早期做出更智能的维护决策,这种方法有助于:  减少意外停工  提升设备可靠性  优化维护周期  降低整体运营成本
关键词:
发布时间:2026-09-08 10:17 阅读量:265 继续阅读>>
海康存储亮相FMW2026全球闪存峰会 斩获<span style='color:red'>AI</span>算力性能标杆大奖
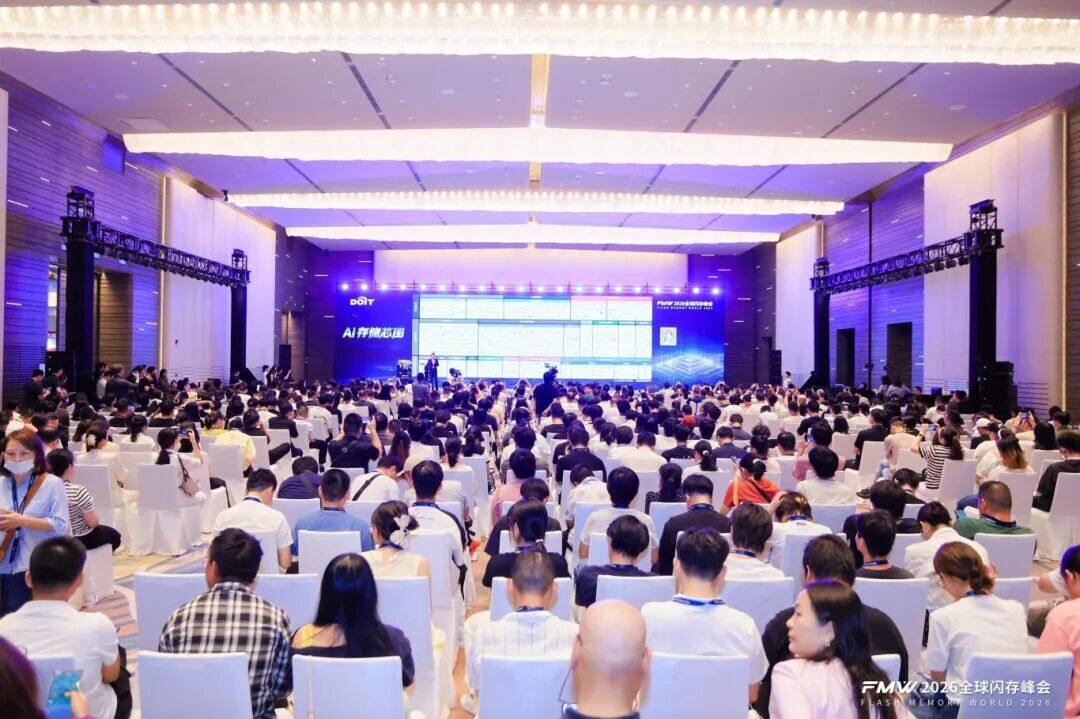
  8月26日,以“存力跃迁,AI破局”为主题的2026全球闪存峰会(FMW)在武汉隆重启幕。本届峰会聚焦存储产业前沿发展趋势,围绕存算一体化技术迭代、闪存介质创新突破、AI原生存储系统构建等核心热点展开深度研讨,汇聚了存储产业链上下游头部企业,搭建高端化、专业化的产业交流与技术共创平台。  本次盛会集结了得瑞领新、华为、紫光闪芯、长江存储等存储上游核心厂商,以及联想、NetApp、浪潮信息等下游服务器与存储系统龙头企业,全方位展现全球闪存与AI存储产业的前沿技术成果、产品方案与未来发展趋势。  海康存储作为参展商之一,与产业链上下游合作伙伴深入交流,共同探讨AI技术高速迭代下,存储产业的变革机遇、技术革新与生态共建路径。  01  重磅产品斩获“AI算力基石性能标杆奖”  彰显AI算力存储硬实力  峰会现场,海康存储携数据中心级、工业控制级全场景存储产品矩阵协同亮相,搭建起分层、全覆盖的存储产品体系,精准匹配AI算力、云计算、工业数字化等多领域核心需求,全方位展现品牌的技术沉淀与完善的产品布局。  其中,R1 DDR5 RDIMM服务器内存模组凭借出色的场景适配能力与稳定的运行表现,成功斩获“2026年度AI算力基石性能标杆奖”,充分印证了海康存储在AI服务器内存领域的前沿技术水平与产品实力。  02  三层立体化产品矩阵  全覆盖赋能算力与与工业场景  海康存储本次展出产品构建了三层产品矩阵,纵向覆盖高性能内存、企业级固态存储、工业级嵌入式存储,层层赋能不同场景核心算力与存储需求,实现数据中心、工业控制全场景精准落地。  算力内存层以R1 DDR5 RDIMM服务器内存模组为核心,精准聚焦AI模组训练、智能推理等密集型工作负载,直击算力场景中内存访问延迟敏感的核心痛点。  产品搭载寄存器信号优化技术与8位奇偶校验信号纠错机制,有效保障高并发、高速运算场景下的数据传输精准度与系统运行稳定性;同时R1提供16/32/64GB多规格容量选择,频率覆盖4800/5600/6400MHz,可灵活适配不同算力规模的服务器配置需求,为AI训练、推理等密集型工作负载提供坚实的内存底层支撑。  数据中心层由D300系列钽电容SATA III固态硬盘坐镇,主要适配数据中心操作系统启动、温数据存储等核心场景。  产品搭载专属钽电容断电保护技术,搭配稳定均衡的读写性能,能够有效规避断电故障带来的数据丢失、文件损坏等问题,可靠性大幅提升。同时产品兼容传统存储架构,为行业用户提供从传统HDD机械硬盘向SSD固态硬盘平滑迁移的高效解决方案,助力数据中心存储架构低成本、高效率升级。  工业边缘存储层依托V310系列SATA III SSD、PTS13 PCIe Gen4×4 SSD与PTS11 PCIe Gen3×4 SSD多款核心产品全面覆盖,全方位适配工业控制、嵌入式设备、高性能边缘计算等多元场景。  产品针对性优化硬件性能,可满足宽温运行、高耐久、小型化、高抗震等严苛工业环境需求,适配从常规工业自动化应用到高端边缘算力部署的全层级场景,夯实工业数字化、边缘智能化的存储底座。  海康存储三层产品矩阵形成了从极致性能内存到大容量固态存储、从云端算力中心到工业边缘终端的全维度覆盖,精准匹配AI大模型训练推理、云计算及工业数字化等场景的多元存储需求,充分展现了品牌全场景、高适配、高可靠的存储产品核心优势。  本次R1 DDR5 RDIMM斩获行业大奖,更是市场与行业对海康存储研发实力、产品品质与场景创新能力的高度肯定。  立足AI高速发展的产业浪潮,未来,海康存储将持续深耕存储核心技术研发,以创新产品与解决方案赋能AI时代的数据基础设施建设,助力千行百业的数字化转型与智能化升级。
关键词:
发布时间:2026-08-27 10:44 阅读量:319 继续阅读>>
昆仑芯联合蚂蚁密算打造国产GPU机密计算方案,夯实国产<span style='color:red'>AI</span>安全算力底座
近日,中国信息通信研究院泰尔终端实验室(以下简称“泰尔终端实验室”)正式发布国内首份面向通用 GPU TEE(可信执行环境)的专项系统检测报告。本次测评是国内首次针对通用GPU可信执行环境技术开展权威专业评测,围绕安全隔离、远程证明、密态大模型推理安全保护三大核心维度完成严苛验证。作为首批完成适配的国产AI算力平台之一,昆仑芯P800系列产品已全面兼容该GPU TEE方案,双方共同打造兼具高性能、高安全的国产AI可信计算解决方案,为企业级大模型部署提供更加安全可靠的算力底座。依托昆仑芯P800系列产品与蚂蚁密算通用GPU TEE HyperGPU技术,该方案无需更换现有硬件,即可为昆仑芯GPU平台赋予可信执行能力,实现模型权重、用户提示词、推理结果等敏感数据在GPU计算过程中的硬件级安全保护,覆盖安全隔离、远程证明、密态推理等关键能力,有效解决AI训练与推理过程中“数据在用即裸奔”的行业难题,为国产AI算力筑牢硬件级数据安全底座。该方案通过在昆仑芯P800系列产品的AI服务器部署由蚂蚁密算团队提供的整套GPU TEE,即可为昆仑芯GPU平台赋予可信执行能力,整个P800的软件栈可以完整运行在蚂蚁密算团队提供的GPU TEE中实现正常业务操作。根据泰尔系统实验室测试结果,在开启全链路密态保护及最高级别安全防护的情况下,该方案推理性能损耗低于2%,实现安全能力与计算性能兼顾。基于昆仑芯领先的AI算力性能和完备的软件生态,结合蚂蚁密算机密计算技术,双方为数据敏感行业提供兼具高性能、高安全、自主可控的大模型基础设施解决方案。作为业界领先的AI计算芯片及软硬件系统供应商,昆仑芯科技始终坚持开放生态发展理念,持续完善芯片、集群系统和软件平台能力,已完成对国内主流模型的快速适配,并不断携手产业伙伴推动国产AI基础设施能力升级。此次与蚂蚁密算联合推进GPU可信执行环境落地,是昆仑芯在完善AI基础设施安全能力方面的重要实践,也进一步拓展了国产AI算力平台在机密计算领域的应用边界。未来,双方将围绕大模型训练、推理及多方协同计算等场景持续深化合作,加快国产算力可信执行环境在更多行业和应用场景中的落地,推动国产AI基础设施实现计算性能、安全可信与自主可控能力的协同提升,为大模型规模化应用提供更加坚实的安全算力底座。
关键词:
发布时间:2026-08-26 13:28 阅读量:384 继续阅读>>
泰晶科技邀您相约2026 IOTE,解锁<span style='color:red'>AI</span>oT时代“芯”心跳
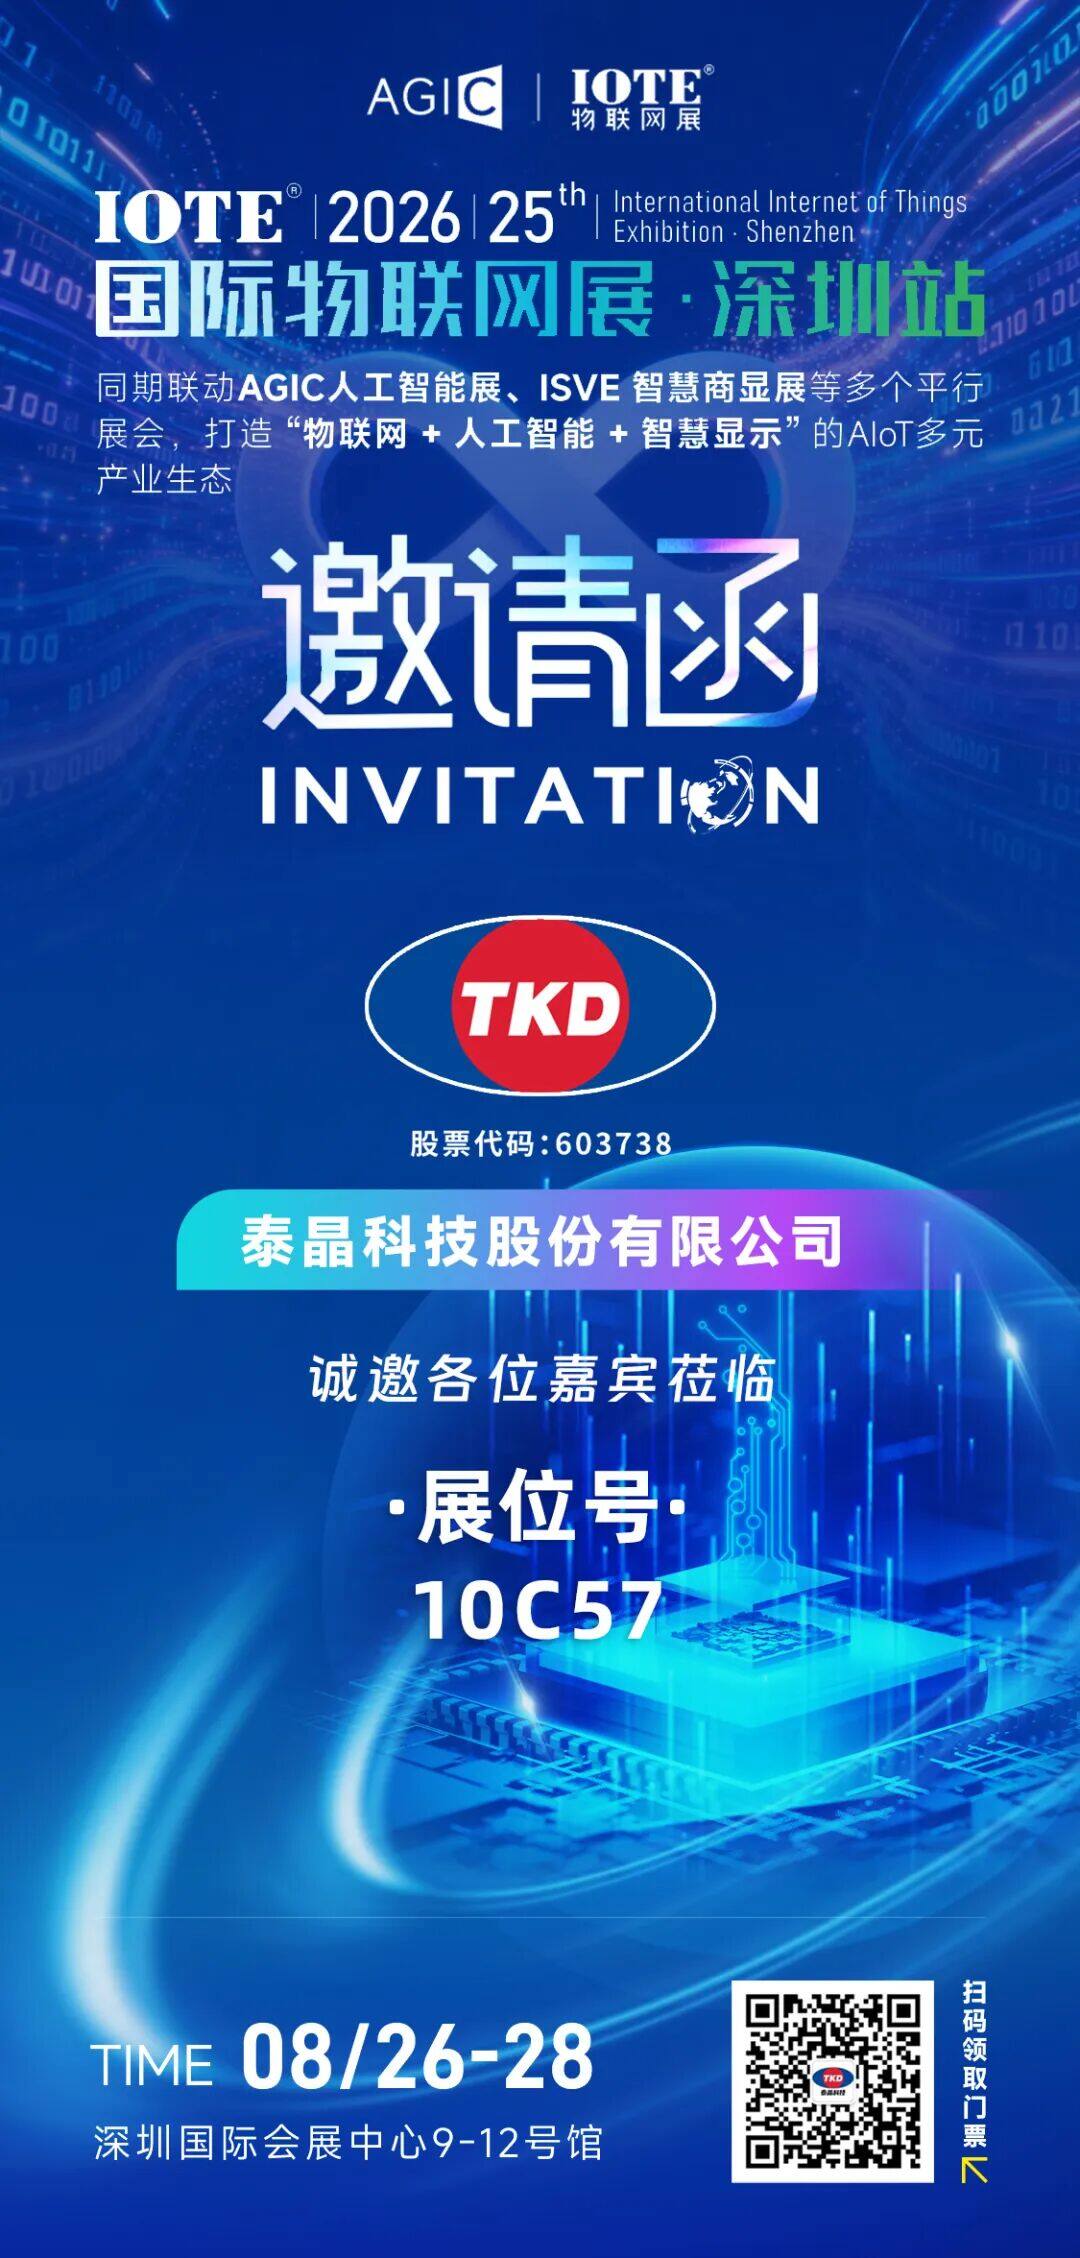
  IOTE 2026 第二十五届国际物联网展·深圳站,将于2026年8月26-28日在深圳国际会展中心(宝安新馆)举办。本届展会联动 AGIC人工智能展,覆盖AI芯片、大模型、智慧城市、工业物联网等物联网全产业链,打造全球 AIOT 生态盛会。  泰晶科技(展位号:10C57)将携前沿时频解决方案亮相本次展会,带来覆盖光通信、AI算力、汽车电子、工业物联网及智慧终端等多场景的全系列时频产品矩阵。  在光通信领域,泰晶科技将重点展示适配800G/1.6T/3.2T高速光模块的312.5MHz超低抖动差分振荡器,有效解决高算力场景下的信号完整性与散热难题;在AI算力方面,展出面向AI服务器、智能网卡及高速互连设备的100MHz-300MHz宽高基频差分晶振方案,为算力时代提供稳定可靠的时频底座;在汽车电子领域,带来通过AEC-Q200/Q100车规认证的全系列车规级晶振,耐受-40℃至125℃极端温差,服务于智能驾驶、车载电子等关键系统;同时,针对工业物联网与智慧终端,展出微型化SMD晶振、高精度温补晶振(TCXO)及全国产化RTC实时时钟模组等产品,广泛适配智能电表、工业控制、可穿戴设备及智能家居等多元场景。  多元适配的时频底座方案正赋能上下游客户,加速智能化产业升级进程。8月26-28日,深圳国际会展中心10C57展位,泰晶科技诚邀各位嘉宾莅临交流,共探AIoT时代的时频新机遇!
关键词:
发布时间:2026-08-26 10:42 阅读量:338 继续阅读>>

跳转至

/ 46

  • 一周热料
  • 紧缺物料秒杀
型号 品牌 询价
TL431ACLPR Texas Instruments
RB751G-40T2R ROHM Semiconductor
CDZVT2R20B ROHM Semiconductor
MC33074DR2G onsemi
BD71847AMWV-E2 ROHM Semiconductor
型号 品牌 抢购
ESR03EZPJ151 ROHM Semiconductor
BP3621 ROHM Semiconductor
STM32F429IGT6 STMicroelectronics
TPS63050YFFR Texas Instruments
BU33JA2MNVX-CTL ROHM Semiconductor
IPZ40N04S5L4R8ATMA1 Infineon Technologies
热门标签
ROHM
Aavid
Averlogic
开发板
SUSUMU
NXP
PCB
传感器
半导体
关于我们
AMEYA360商城(www.ameya360.com)上线于2011年,现有超过3500家优质供应商,收录600万种产品型号数据,100多万种元器件库存可供选购,产品覆盖MCU+存储器+电源芯 片+IGBT+MOS管+运放+射频蓝牙+传感器+电阻电容电感+连接器等多个领域,平台主营业务涵盖电子元器件现货销售、BOM配单及提供产品配套资料等,为广大客户提供一站式购销服务。

请输入下方图片中的验证码:

验证码